


DeepSeek V4.1 Flash introduce un’architettura che riduce drasticamente il consumo di memoria del contesto: il KV-cache richiede circa un quarto della HBM di V4 Flash. Il modello ha 552 miliardi di parametri, ma ne attiva circa 8 miliardi nell’elaborazione e 16 miliardi nella generazione, supportando contesti fino a un milione di token.
DeepSeek ha dimostrato che un modello gigante non deve necessariamente consumare proporzionalmente più memoria. L’azienda ha presentato DeepSeek V4.1 Flash, dove il KV-cache richiede solo un quarto di HBM rispetto a V4 Flash. Si tratta specificamente della memoria per il contesto, non di una riduzione quadrupla di tutta la memoria necessaria per i pesi del modello. Per i servizi multiutente, la differenza è particolarmente importante.
La base di V4.1 Flash contiene 552 miliardi di parametri, mentre la memoria condizionale separata Engram ne aggiunge altri 196 miliardi. L’intero set di file su Hugging Face raggiunge circa 763 miliardi di parametri, inclusi i componenti ausiliari. Tuttavia, il modello attiva circa 8 miliardi di parametri durante l’elaborazione di una richiesta e 16 miliardi durante la generazione di una risposta, quindi le dimensioni dei pesi e il carico computazionale non crescono allo stesso modo.

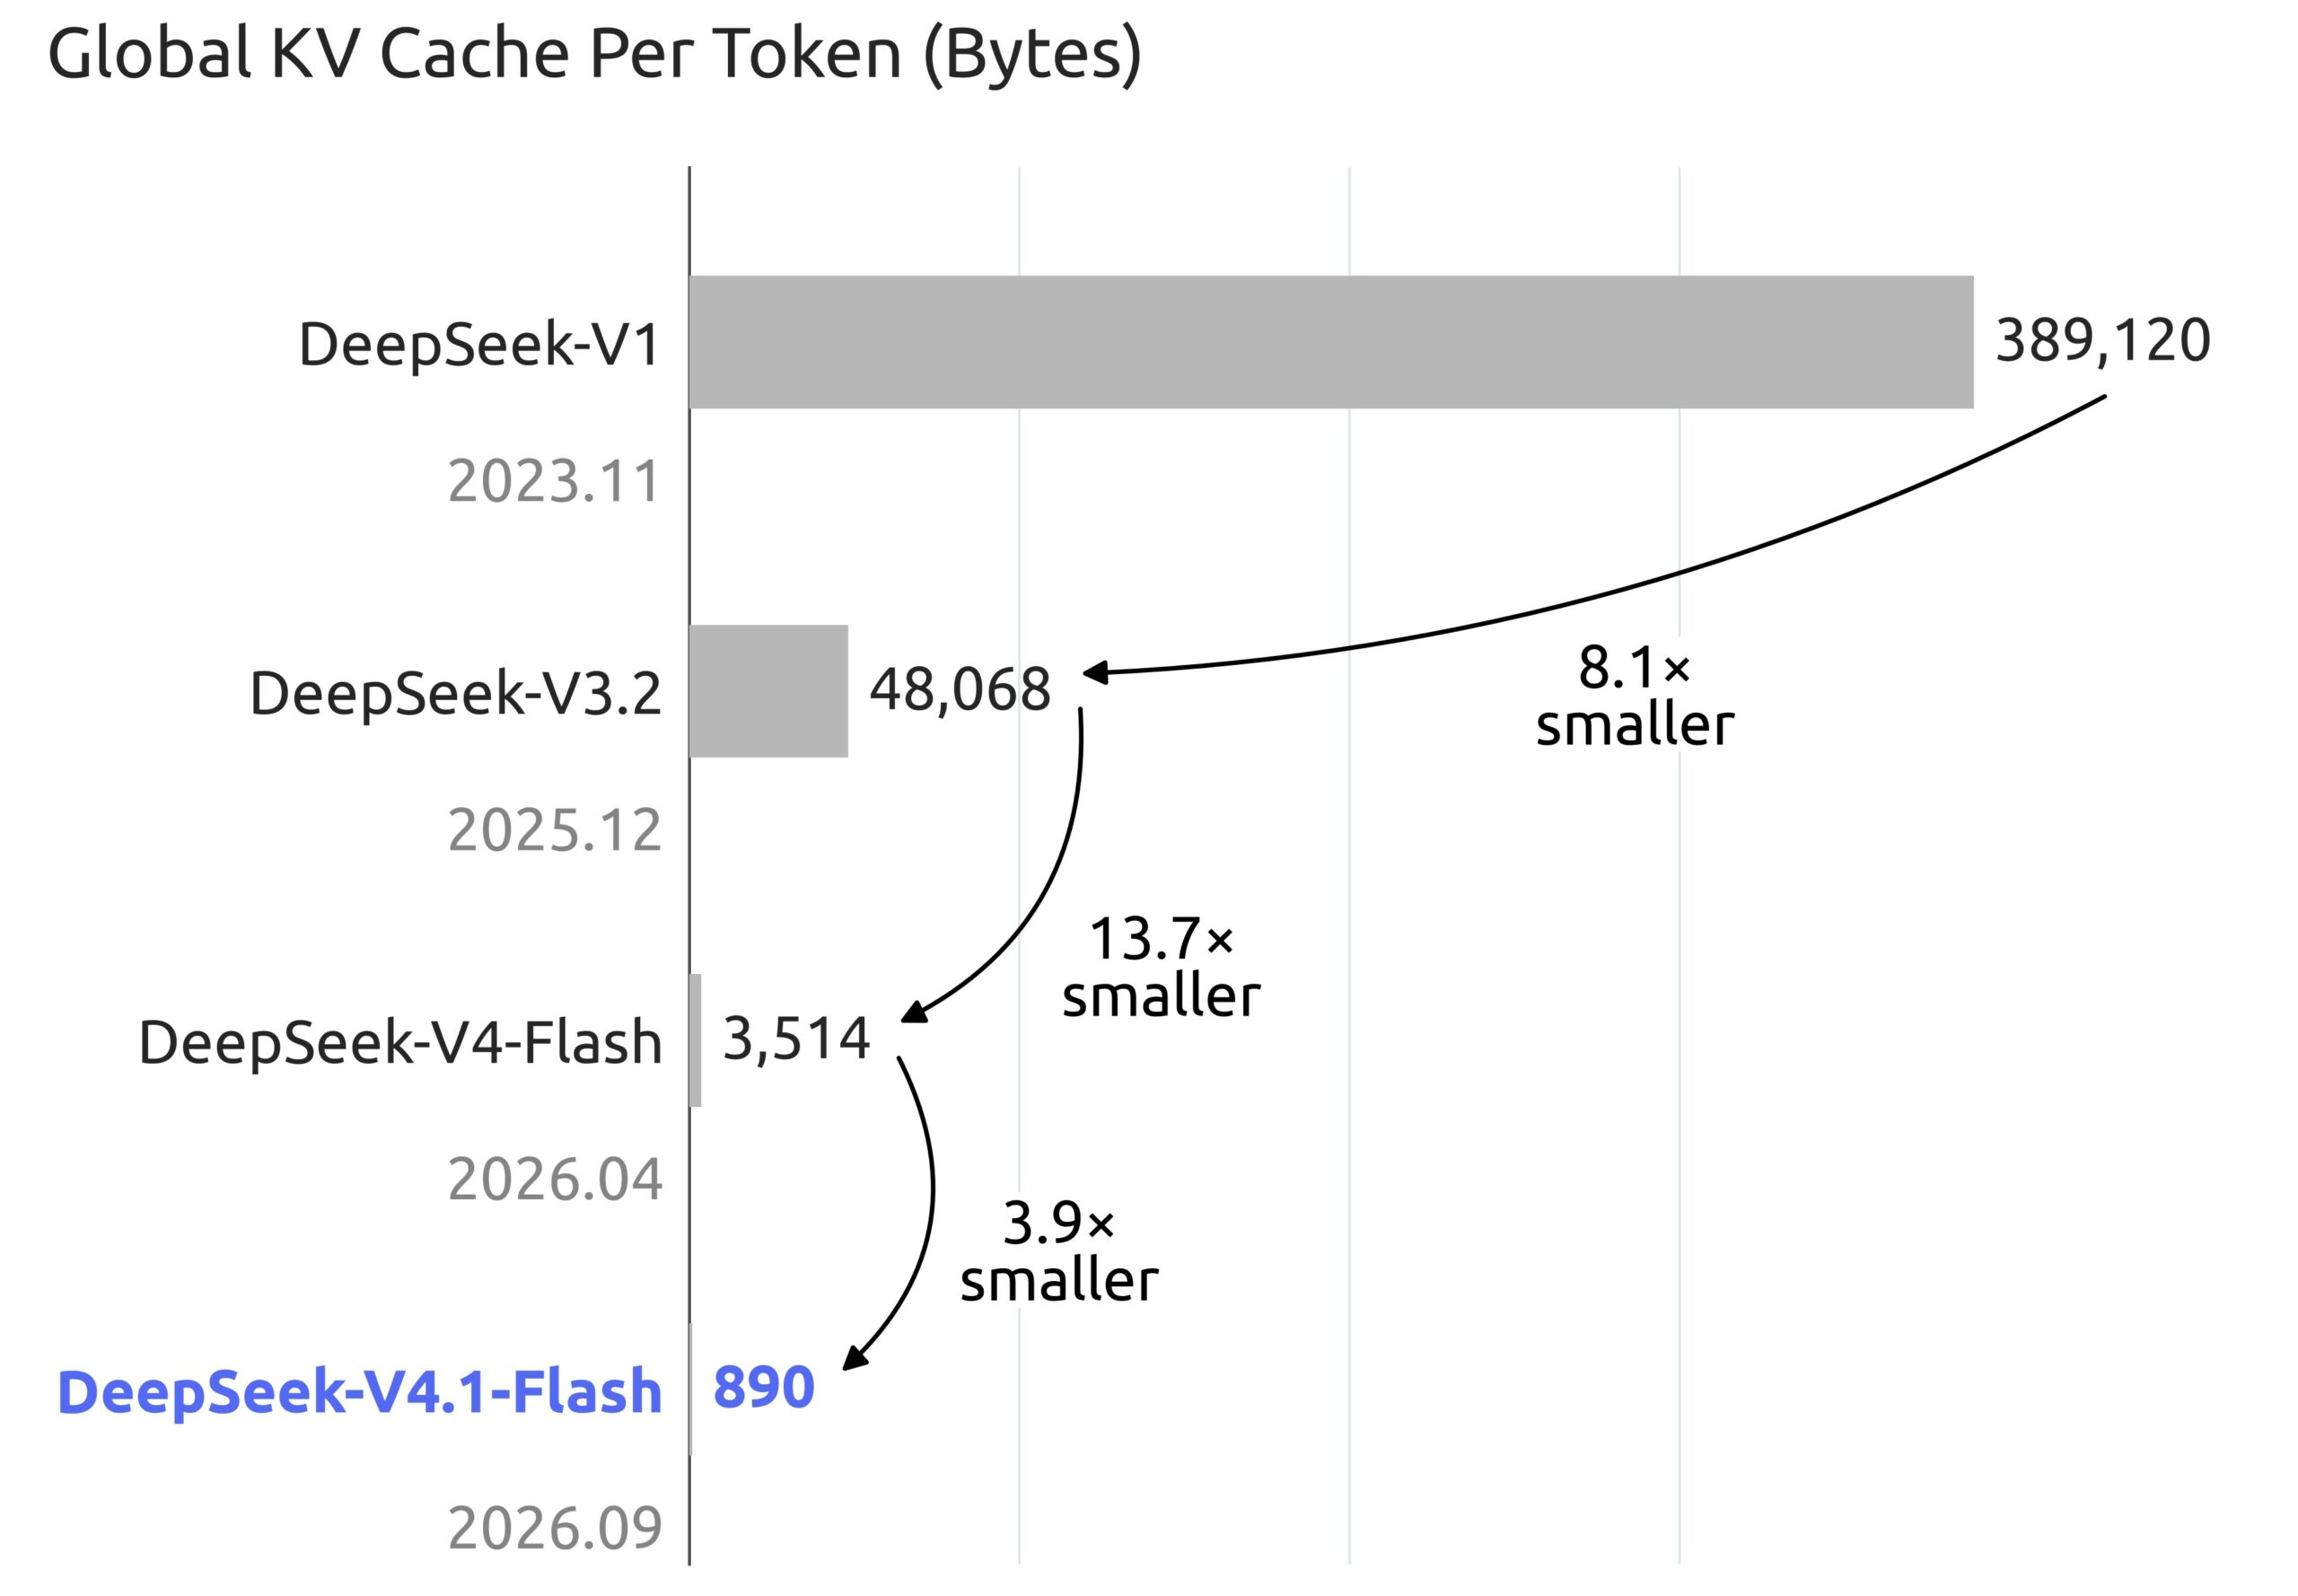
La principale economia deriva dalla nuova scheda Causal Encoder-Decoder. Venti livelli dell’encoder elaborano prima l’input, dopo di che venti livelli del decoder ricevono un KV-cache comune dallo stato finale dell’encoder, invece di creare copie complete separate a ogni livello. Nella descrizione del modello DeepSeek indica una dimensione del KV-cache globale di 890 byte per token. Tale cache memorizza lo stato del contesto già elaborato.
Inoltre, Compressed Sparse Attention 2 riutilizza i dati di attenzione tra i livelli, mentre le principali voci del KV-cache sono memorizzate in FP4.
La cache permanente, che deve essere trasferita sui dispositivi di accumulo, è stata ridotta a circa un ottavo rispetto a V4 Flash. Questo approccio continua la strada che DeepSeek ha già scelto in V4, dove gli sviluppatori hanno ridotto anche il costo del contesto lungo.
L’economia di HBM è particolarmente evidente sullo sfondo del deficit di HBM, che alimenta il boom dell’infrastruttura IA.
Meno memoria occupa il contesto di ogni utente, più sessioni simultanee possono essere gestite sugli stessi acceleratori. DeepSeek stima il guadagno del KV-cache di circa quattro volte rispetto a V4 Flash e di 437 volte rispetto alla prima generazione.
V4.1 Flash supporta un contesto fino a un milione di token e sa lavorare con testo e immagini. Il modello è già disponibile tramite API ed è stato pubblicato con pesi aperti sotto licenza MIT.
V4 Flash l’azienda lo ha già rimosso dall’API, e dal 14 settembre le richieste a V4 Pro verranno temporaneamente indirizzate a V4.1 Flash fino al rilascio di V4.1 Pro. La nuova architettura è progettata per un ulteriore scalamento.

RHC4Edu nasce dalla volontà della community di Red Hot Cyber di portare la cultura della cybersecurity, dell’intelligenza artificiale e del digitale direttamente nelle scuole, mettendo gratuitamente a disposizione degli studenti l’esperienza di professionisti, ricercatori e specialisti del settore. Il progetto è ufficialmente operativo e permette agli istituti interessati di richiedere workshop gratuiti e incontri con gli esperti della community, attraverso un coordinamento della redazione che mette in relazione le esigenze della scuola con le competenze e la disponibilità dei professionisti presenti sul territorio.
L’obiettivo di RHC4Edu non è trasformare gli studenti in tecnici informatici, ma aiutarli a sviluppare consapevolezza e pensiero critico davanti a un mondo sempre più digitale. Cybersecurity, truffe online, privacy, social network, cyberbullismo, fake news e intelligenza artificiale diventano così argomenti da affrontare con esempi concreti e con il contributo diretto di chi lavora quotidianamente nel settore. Un’iniziativa costruita sulla condivisione della conoscenza e sul volontariato della community, perché portare queste competenze nelle aule significa anche offrire ai ragazzi la possibilità di conoscere nuove professioni, sviluppare curiosità e imparare a vivere la tecnologia in modo più sicuro e consapevole.
Prenota il tuo workshop gratuito con gli esperti di Red Hot Cyber.