


La Cina sfida i giganti dell’intelligenza artificiale con Kimi K3.1 Pro, il modello di Moonshot AI che raggiunge 55 punti nell’Artificial Analysis Intelligence Index, superando i modelli OpenAI nei benchmark citati. Potenziato per gli agenti AI, la programmazione e le attività complesse, promette prestazioni avanzate e costi ridotti. I pesi aperti sono attesi il 4 novembre 2026
La laboratorio cinese di intelligenza artificiale Moonshot AI ha presentato Kimi K3.1 Pro — una versione aggiornata del modello Kimi K3, che ha subito un ulteriore addestramento utilizzando un volume maggiore di risorse di calcolo. Nella classifica Artificial Analysis Intelligence Index ha ottenuto 55 punti, superando il predecessore di 11 punti, superando tutti i modelli OpanAI e occupando la quarta posizione.
Al di sopra di Kimi K3.1 Pro nella classifica si sono posizionati Anthropic Claude Opus 5.5 (58 punti), Claude Sonnet 5.5 (56 punti) e Meta Muse Wonder Full (56 punti). Moonshot AI intende aprire i pesi del modello il 4 novembre, e diventerà la più potente nella classe delle sistemi aperti. Il divario tra modelli aperti e proprietari si ridurrà da 12 a 3 punti, se la situazione sul mercato non cambierà entro quel momento. Lo sviluppatore ha anche rilasciato la versione Kimi K3.1 Pro Highspeed — funziona da due a tre volte più velocemente. Entrambi i modelli sono già disponibili sulle piattaforme Kimi.ai, Kimi Work, Kimi Code e tramite API.
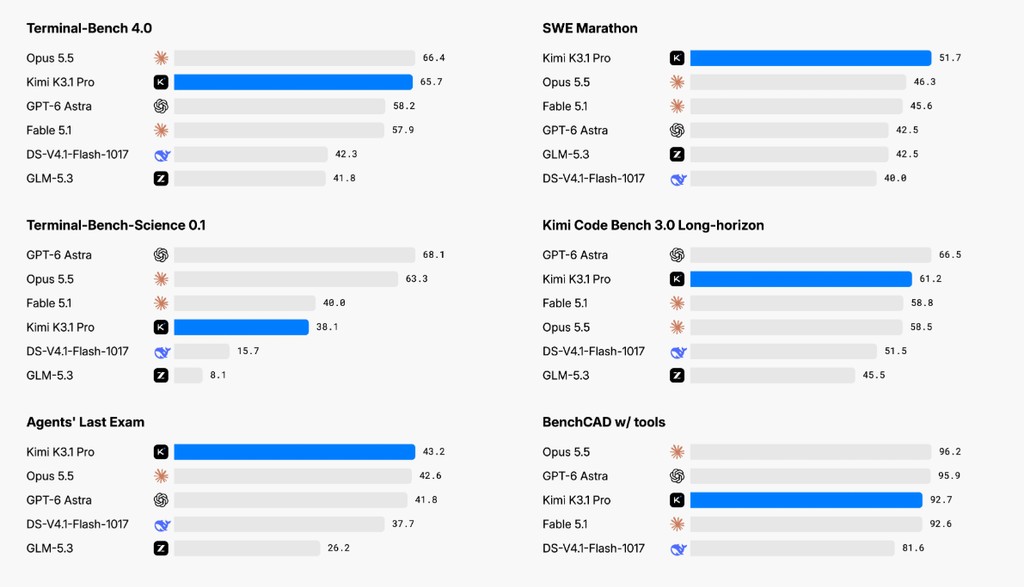

Il progresso più evidente di Kimi K3.1 Pro si è manifestato nelle attività agent-based: nel benchmark GDPval-AA ha ottenuto 1846 punti Elo, superando K3 di 312 punti. Qui ha ceduto solo a Claude Opus 5.5 (1866 punti) e Wonder Full (1857 punti). In Terminal-Bench 4.0 ha dimostrato il 65,7%, superando OpenAI GPT-6 Astra (58,2%) e cedendo di poco a Claude Opus 5.5 (66,4%) — K3 nello stesso test ha ottenuto solo il 13%.
Nel corso di un test interno, Kimi Hallu Bench Hard, la percentuale di allucinazioni, ovvero risposte chiaramente non corrispondenti alla realtà, è diminuita dal 23,4% di K3 all’8,3% del nuovo modello. Si tratta di un test di stress, non di un indicatore del livello generale di errori, hanno sottolineato in Moonshot; per confronto, GPT-6 Astra nello stesso test ha ottenuto il 5,5%, mantenendo quindi il vantaggio. Nei test finanziari Kimi K3.1 Pro ha mostrato un incremento di 7,2 punti nella direzione del modeling finanziario e di 11,6 punti nelle ricerche finanziarie. Nel benchmark OfficeQA Pro v2 legato a compiti da ufficio, il modello ha superato tutti i concorrenti, afferma Moonshot.
Kimi K3.1 Pro supporta l’interazione diretta con i motori di gioco, tra cui Unity, Unreal Engine e Godot — può apportare correzioni operative e produrre la compilazione dei progetti. Utilizzando strumenti ausiliari nel test BenchCAD ha ottenuto il 92,7%, avvicinandosi ai risultati di Claude Opus 5.5 (96,2%) e GPT-6 Astra (95,9%). Senza l’uso di strumenti il risultato è sceso al 72,8%, quasi uguale al risultato di Claude Opus 5.5 (73,0%). Il modello si comporta meglio nel modeling parametrico di parti meccaniche, oggetti architettonici e oggetti con parametri configurabili. Sa creare e eseguire script per Blender e sistemi CAD senza MCP-connector. Sulla piattaforma Kimi.com è apparsa la funzione 3D Make — permette di visualizzare, modificare ed esportare modelli tridimensionali.
Il modello Kimi K3.1 Pro ha ereditato le dimensioni del predecessore — 2,8 trilioni di parametri, di cui 104 miliardi attivi. La finestra di contesto ha una dimensione di 1 milione di token, supporta il lavoro con testo e immagini. Secondo i dati di Artificial Analysis, si trova al vertice del “fronte di Pareto“; ha il punteggio più alto di Intelligence Index tra i modelli di dimensioni comparabili.
Il costo di esercizio è diminuito del 33%: $2 per 1 milione di token di input (era $3), $10 per 1 milione di token di output (era $15) e $0,20 per il lavoro con dati memorizzati nella cache (era $0,30). L’esecuzione di un compito dal set Intelligence Index costa $1,98 — quasi quanto per K3 ($2,00) – mentre il nuovo modello genera il 14% in più di token di output.
Con il progressivo miglioramento della fase di post-addestramento, le capacità del modello di ricerca di vulnerabilità si sono rafforzate, hanno notato in Moonshot: i materiali relativi alla cybersicurezza erano presenti nel dataset generale, i compiti corrispondenti sono stati inclusi nell’ambiente di apprendimento per rinforzo. Nella preparazione della versione con pesi aperti, lo sviluppatore ha rimosso i dati relativi alla cybersicurezza in entrambe le fasi di addestramento. Durante i test interni con il benchmark xdev-bench-hard, che include vulnerabilità recentemente scoperte nel kernel Linux, Node.js e JavaScriptCore, la versione originale del modello ha superato con successo il 90,5% dei compiti; dopo la rimozione dei dati, questo indicatore è sceso all’81,0%. Per confronto, nello stesso test DeepSeek-V4.1-Flash ha ottenuto l’85,7%, mentre Kimi K3 ha ottenuto il 33,3%.
I modelli con pesi aperti non dovrebbero espandere i confini delle possibilità nel campo della cybersicurezza offensiva, ritengono in Moonshot. Allo stesso tempo, il laboratorio mira a migliorare gradualmente le funzionalità dei modelli aperti, perché potrebbero rivelarsi utili anche nella difesa — ad esempio, nell’analisi di sistemi obsoleti. In precedenza, Anthropic ha dimostrato che il modello cinese Z.ai GLM-5.3 con 45 punti nell’AA Index è in grado di creare exploit, per livello di complessità comparabili a quelli generati da Claude Mythos.

Sono ufficialmente aperte le adesioni al Program Sponsor della Red Hot Cyber Conference 2027, la sesta edizione dell’evento annuale gratuito promosso dalla community di Red Hot Cyber per diffondere cultura, competenze e consapevolezza sui temi della cybersecurity, dell’innovazione e delle tecnologie digitali. La Conference si terrà a Roma, martedì 18 e mercoledì 19 maggio 2027, presso l’Auditorium del Seraphicum, nel cuore del quartiere EUR, con una giornata dedicata ai workshop pratici e alle attività tecniche e una seconda giornata interamente dedicata alla conferenza.
Anche per il 2027, le aziende potranno scegliere di sostenere concretamente il progetto attraverso il Program Sponsor, partecipando alla crescita di un appuntamento che mette in relazione professionisti, aziende, istituzioni, studenti, ricercatori e appassionati di tecnologia. Il programma prevede la possibilità di aderire come Sponsor Sostenitore, una formula pensata per le aziende che desiderano essere tra le prime realtà a credere e contribuire alla realizzazione della nuova edizione, oppure attraverso i tre consueti livelli di sponsorizzazione Platinum, Gold e Silver. Ogni livello di sponsorizzazione acquistato, sarà accompagnato da un pacchetto Advertising, con l'opportunità di visibilità attraverso articoli, banner e contenuti all’interno del circuito editoriale di Red Hot Cyber.
Le aziende interessate a conoscere le formule disponibili, il Media Kit e tutte le opportunità previste dal Program Sponsor 2027 possono richiedere informazioni scrivendo a [email protected].