


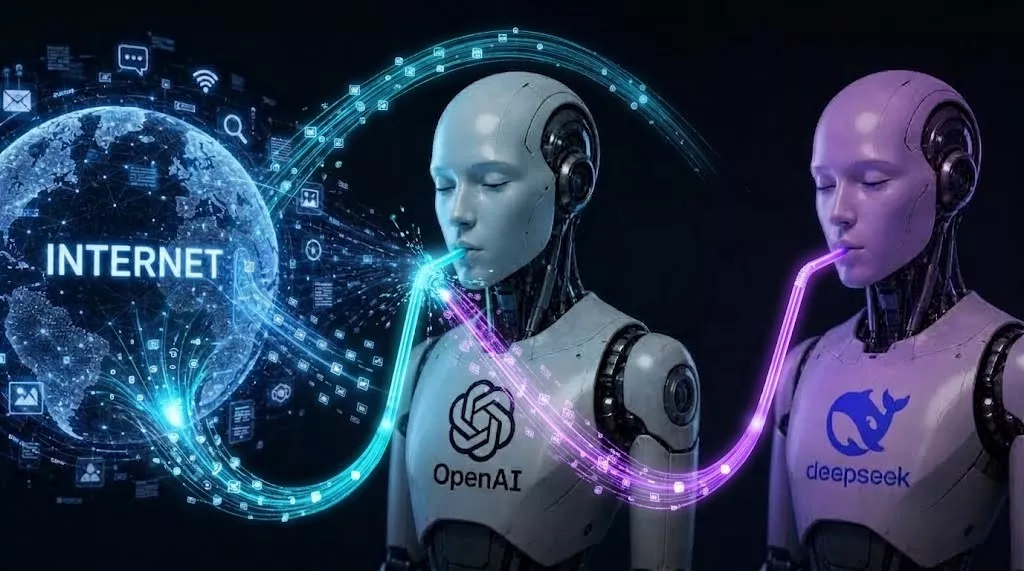
CISA, NSA e FBI accusano aziende cinesi come Alibaba, DeepSeek e Moonshot AI di distillare illegalmente modelli americani attraverso milioni di richieste e migliaia di account falsi. Ma la vicenda apre un paradosso: i laboratori AI hanno imparato da Internet violando leggi e copyright, ora rivendicano il diritto a non essere imitate.
Gli esperti dell’Agenzia per la Sicurezza Informatica e la Protezione delle Infrastrutture degli Stati Uniti (CISA), della NSA e dell’FBI hanno dichiarato che le aziende cinesi di intelligenza artificiale stanno distillando su larga scala i modelli di intelligenza artificiale americani per addestrare i propri sistemi. Si parla di miliardi di token e milioni di richieste a Claude, GPT, Gemini e Grok. Quasi contemporaneamente, gli esperti di Anthropic hanno rivelato i dettagli di sette campagne di questo tipo, mirate a Claude. La più grande di queste è collegata ad Alibaba, che ha inviato ai modelli oltre 151 milioni di richieste da maggio a luglio 2026.
La distillazione in sé rappresenta un metodo di apprendimento comune, in cui un modello più potente funge da “insegnante” e le sue risposte vengono utilizzate per addestrare un modello più giovane. Tuttavia, le agenzie americane affermano che DeepSeek, Moonshot AI, Alibaba, MiniMax, StepFun e Z.AI stanno applicando questa tecnica senza il permesso delle aziende americane e su larga scala.

Secondo le stime di CISA, NSA e FBI, queste campagne vengono condotte almeno dalla fine del 2024 e, molto probabilmente, con il consenso delle autorità cinesi. Gli esperti ritengono che la distillazione non sia semplicemente uno strumento ausiliario, ma una delle principali strategie nello sviluppo dei modelli cinesi.
Si nota che per accedere ai modelli vengono utilizzati API, piattaforme cloud, aggregatori di terze parti e servizi proxy. Gli operatori di questi servizi creano migliaia di account falsi, utilizzando identità fittizie, carte di credito false o rubate e chiavi API rubate. In questo modo, i laboratori di intelligenza artificiale cinesi possono nascondere l’origine delle richieste e aggirare i limiti.
Contemporaneamente, i rappresentanti di Anthropic hanno riferito di aver scoperto, a partire da febbraio 2026, sette laboratori cinesi impegnati nella distillazione non autorizzata di Claude.
L’attività più evidente è collegata ad Alibaba: gli esperti hanno registrato oltre 151 milioni di richieste a Claude Opus 4.6 e 4.7 da parte di Alibaba nel periodo da maggio a luglio dell’anno corrente. Nei momenti di picco, l’attività ha raggiunto quasi i 3 milioni di richieste al giorno, per la generazione delle quali sono stati utilizzati più di 3500 account falsi.
Secondo i dati di Anthropic, le catene di ragionamento raccolte in questo modo sono state utilizzate per addestrare i modelli Qwen.
In Anthropic affermano che particolarmente degni di nota sono i metodi utilizzati dagli sviluppatori di Moonshot AI e DeepSeek. Il fatto è che entrambe le aziende hanno reindirizzato silenziosamente parte delle richieste dei propri utenti a Claude, conservando le risposte ottenute per addestrare i propri modelli. Di conseguenza, gli utenti credevano di interagire con Kimi o DeepSeek, mentre in realtà stavano interagendo con Claude.
Secondo i calcoli degli esperti, da maggio a luglio 2026, Moonshot AI ha inviato a Claude oltre 23 milioni di richieste, mentre nel caso di DeepSeek gli esperti hanno registrato più di 12,1 milioni di richieste in soli 14 giorni a luglio.
Gli esperti scrivono che tale schema creava anche ulteriori problemi di riservatezza: nelle richieste reindirizzate a Claude si trovavano codici interni di aziende, documenti aziendali, nomi, dati di contatto e credenziali attive.
Ad esempio, tramite DeepSeek sono state caricate in Claude credenziali attive per accedere al database di un ente governativo russo non specificato, mentre tramite Moonshot sono stati trasmessi ai modelli di Anthropic richieste di un ingegnere di una società statale cinese, contenenti codici interni e segreti di diverse organizzazioni.
Ma le AI americane non leggevano i dati degli utenti?
Per anni l’industria dell’intelligenza artificiale ha costruito i propri modelli attingendo a una quantità sterminata di informazioni presenti su Internet: testi, libri, siti web, forum, codice, immagini e contenuti prodotti da milioni di persone senza il consenso. Oggi, però, quelle stesse aziende denunciano come una grave violazione il fatto che altri modelli utilizzino le loro risposte per imparare. E la cosa più preoccupante che i governi dei paesi dove si sviluppano queste AI producano bollettini di sicurezza sulla più grande violazione del copyright mai fatta al mondo.
Ma forse questa è una delle domande più profonde che la guerra tra AI americane e cinesi ci sta ponendo: quando una macchina impara da ciò che un altro essere umano ha prodotto, dove finisce l’apprendimento e dove comincia il furto?
Perché se il futuro dell’intelligenza artificiale consiste nel far imparare le macchine le une dalle altre, prima o poi saremo costretti a stabilire una regola fondamentale: chi possiede davvero ciò che un’intelligenza artificiale ha imparato?

RHC4Edu nasce dalla volontà della community di Red Hot Cyber di portare la cultura della cybersecurity, dell’intelligenza artificiale e del digitale direttamente nelle scuole, mettendo gratuitamente a disposizione degli studenti l’esperienza di professionisti, ricercatori e specialisti del settore. Il progetto è ufficialmente operativo e permette agli istituti interessati di richiedere workshop gratuiti e incontri con gli esperti della community, attraverso un coordinamento della redazione che mette in relazione le esigenze della scuola con le competenze e la disponibilità dei professionisti presenti sul territorio.
L’obiettivo di RHC4Edu non è trasformare gli studenti in tecnici informatici, ma aiutarli a sviluppare consapevolezza e pensiero critico davanti a un mondo sempre più digitale. Cybersecurity, truffe online, privacy, social network, cyberbullismo, fake news e intelligenza artificiale diventano così argomenti da affrontare con esempi concreti e con il contributo diretto di chi lavora quotidianamente nel settore. Un’iniziativa costruita sulla condivisione della conoscenza e sul volontariato della community, perché portare queste competenze nelle aule significa anche offrire ai ragazzi la possibilità di conoscere nuove professioni, sviluppare curiosità e imparare a vivere la tecnologia in modo più sicuro e consapevole.
Prenota il tuo workshop gratuito con gli esperti di Red Hot Cyber.