


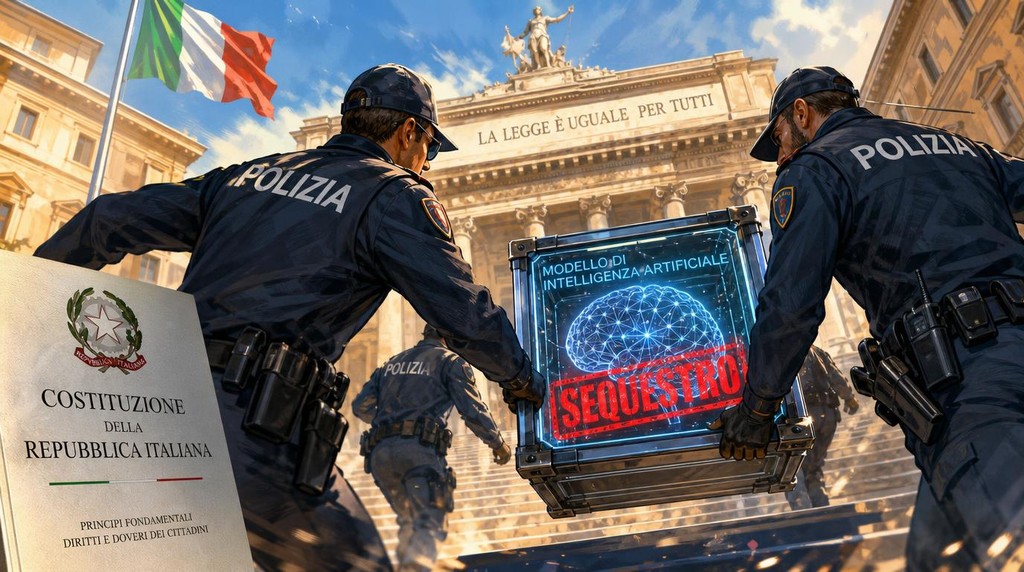
L'articolo analizza le difficoltà giuridiche legate al sequestro di modelli di intelligenza artificiale, evidenziando come i tradizionali strumenti penali risultino inadeguati per le reti neurali. Vengono discussi i principi di proporzionalità, i rischi di paralisi aziendale e le limitazioni tecniche nella separazione dei pesi algoritmici. Si propone il Machine Unlearning come alternativa per rimuovere dati illeciti senza distruggere l'intero modello, garantendo al contempo la continuità operativa e la tutela della proprietà industriale.
Un dilemma di questi tempi in ambito giudiziario è su come come i pubblici ministeri e le forze dell’ordine debbano intervenire quando un sistema algoritmico viene impiegato come strumento per commettere delitti, quali la generazione e diffusione di deepfake, le truffe informatiche evolute, le manipolazioni dei mercati finanziari o la sottrazione di segreti commerciali. Dubbi se vogliamo ancora maggiori si incontrano quando sia la stessa rete neurale ad essere stata costruita ed addestrata incorporando direttamente dati di provenienza illecita.
La difficoltà di comprendendere come intervenire parte dalla banale considerazione che un modello di Intelligenza Artificiale non equivale al semplice codice di un software, né coincide con l’archivio dei dati usati per l’addestramento. Infatti, in questi sistemi il cuore operativo è nei suoi pesi algoritmici, ossia milioni di parametri matematici calcolati al termine dell’apprendimento, che stabiliscono le relazioni tra i dati e determinano le risposte generate dalla macchina. L’impostazione naturale della giurisprudenza è quella di applicare alle reti neurali gli strumenti tradizionali del codice.

Seguendo tale direzione quando l’algoritmo rappresenta il prodotto o l’oggetto dell’illecito, come nel caso di un modello creato con dati aziendali rubati, viene qualificato come corpo del reato. Viene, invece, considerato come cosa pertinente al reato quando funge da mezzo per compiere l’illecito, oppure viene acquisito come semplice dato informatico da isolare e conservare come prova. Si tratta, tuttavia, di un’applicazione di vecchie regole a situazioni nuove che non coglie perfettamente nel segno.
A tal riguardo basti rilevare che, diversamente dai documenti o file multimediali tradizionali, i pesi algoritmici non possiedono un significato leggibile o interpretabile per l’uomo se separati dal loro contesto, ma funzionano solo se eseguiti insieme all’hardware e all’infrastruttura software. Ne consegue che imporre il blocco fisico dei server o il sequestro tradizionale dell’intero sistema se da un lato risulta essere una misura tecnicamente inadeguata, dall’altro si rivela idonea a provocare conseguenze devastanti per l’operatività economica e la continuità aziendale dell’impresa coinvolta.
Per poter procedere ad un sequestro preventivo o probatorio di un modello di intelligenza artificiale occore dover rispettare i principi costituzionali di adeguatezza, proporzionalità e del minimo mezzo, ribaditi dalle norme sovranazionali. Ormai secondo giurisprudenza consolidata vanno considerati illegittimi i sequestri informatici indiscriminati che comportino la totale e automatica apprensione di interi archivi o supporti di memoria quando sia possibile isolare ed estrarre unicamente i dati pertinenti alle indagini.
Quando , tuttavia, ci troviamo di fronte a reti neurali avanzate o a modelli di fondazione, vi è un limite tecnico e matematico insuperabile rispetto al concetto di selezione mirata del dato. Si osserva a tal riguardo come non sia possibile immaginare, sia fisicamente che logicamente, di separare o estrarre la frazione di peso algoritmico correlata alla condotta illecita senza compromettere irrimediabilmente la struttura e il funzionamento dell’intera rete neurale.
Supponiamo che un modello venga addestrato su un insieme di dati contenente una percentuale di informazioni coperte da diritto d’autore, segreti industriali o dati personali trattati in violazione della normativa sul GDPR, in quel caso il valore matematico finale dei pesi rappresenta la sintesi vettoriale e indissociabile di ogni singolo elemento elaborato durante la fase di apprendimento. Tale peculiarità sotto il profilo tecnico fa discendere criticità sostanziali. Se si rende inattiva l’intera rete neurale per inibire una specifica funzionalità ritenuta illecita, si finisce per paralizzare tutte le restanti applicazioni legittime erogate dal sistema a favore di terzi utenti in buona fede.
A ciò si aggiunga che, sul piano del pericolo nel ritardo, per applicare una misura cautelare vi deve essere la prova di un rischio concreto e attuale che la libera disponibilità del bene possa aggravare le conseguenze del reato o agevolare la commissione di ulteriori illeciti. Orbene, è agevole rilevare come questo presupposto non può ritenersi automaticamente integrato quando è possibile soddisfare le esigenze preventive attraverso il blocco dell’interfaccia di comunicazione applicativa o l’implementazione di filtri sugli input e sugli output senza dover disconnettere o sequestrare l’intera architettura. La delicatezza di questo tema è ancora più evidente se parliamo di responsabilità amministrativa degli enti derivante da reato ai sensi del Decreto Legislativo 231 del 2001.
Nel momento in cui sono stati introdotti delitti commessi mediante l’impiego di sistemi di intelligenza artificiale tra i reati presupposto della responsabilità societaria, l’eventuale sequestro impeditivo che venga disposto nei confronti del modello algoritmico principale di una società tecnologica si rivela come sanzione interdittiva ad effetto paralizzante. Nelll’ipotesi in cui il sistema di IA costituisca l’asset primario dell’impresa, privare l’ente della sua operatività può provocare addirittura il dissesto finanziario ed il fallimento prima che attraverso il dibattimento vengano accertate eventuali responsabilità.
Abbiamo visto come i metodi tradizionali della giustizia penale, modellati sull’apposizione fisica dei sigilli o sulla creazione di copie immodificabili di singoli file, siano di fatto inapplicabili per le architetture di Intelligenza Artificiale moderna. Il punto è che quei parametri matematici che rappresentano la mente di un algoritmo non trovano collocazione all’interno di un singolo computer, essendo frammentati in complesse infrastrutture cloud distribuite in tutto il mondo.
Ciò comporta che il blocco indiscriminato può portare allo spegnimento di interi data center del tutto estranei alle indagini. A ciò si aggiunga che di fronte alla natura dinamica dell’IA, che impara e cambia continuamente attraverso l’interazione con l’utenza, qualsiasi copia fotografica scattata dagli inquirenti si rivela obsoleta nel giro di pochi istanti.
D’altra parte se si congela un algoritmo per le esigenze del processo si finisce per impedirne la costante manutenzione e il rilascio delle necessarie patch di sicurezza, condannando l’infrastruttura tecnologica a un rapido ed irreversibile degrado. Vi sono poi altri problemi in materia di tutela della proprietà industriale, visto che i pesi algoritmici rappresentano il segreto commerciale di maggiore valore per un’azienda tech e il loro deposito negli atti di causa rischia di far trapelare l’intero know-how societario a concorrenti e terzi.
Proprio considerata la delicatezza del tema, il Regolamento Europeo sull’IA stabilisce che l’accesso diretto alla struttura interna del modello debba costituire per le autorità una misura eccezionale di estrema ratio.
Posto che emerge una profonda incompatibilità tra le norme procedurali e la realtà tecnologica, occorre, probabilmente, abbandonare l’idea di un sequestro “distruttivo” in favore di interventi funzionali e prescrittivi. Su questo scenario, ruolo centrale riveste il Machine Unlearning, ossia il disapprendimento automatico, una vera e propria chirurgia algoritmica che consente alla rete neurale di rimuovere l’influenza matematica dei soli dati illeciti o riservati senza dover distruggere l’intero modello, né riavviare un lungo e costosissimo processo di addestramento da capo.
Può ipotizzarsi,quindi, anzicchè un blocco totale dell’infrastruttura, l’autorizzazione ad una procedura di bonifica mirata, verificata da esperti, in modo che il sistema possa rimanere attivo per le attività lecite dell’azienda sotto l’applicazione di opportuni filtri di sicurezza o con l’affiancamento di un amministratore giudiziale. Questa potrebbe essere la modalità attraverso la quale garantire da un lato il soddisfacimento delle esigenze cautelari e, dall’altro, la tutela della collettività, salvaguardando al contempo la continuità dell’impresa, i posti di lavoro e il valore dell’innovazione tecnologica.

Sono ufficialmente aperte le adesioni al Program Sponsor della Red Hot Cyber Conference 2027, la sesta edizione dell’evento annuale gratuito promosso dalla community di Red Hot Cyber per diffondere cultura, competenze e consapevolezza sui temi della cybersecurity, dell’innovazione e delle tecnologie digitali. La Conference si terrà a Roma, martedì 18 e mercoledì 19 maggio 2027, presso l’Auditorium del Seraphicum, nel cuore del quartiere EUR, con una giornata dedicata ai workshop pratici e alle attività tecniche e una seconda giornata interamente dedicata alla conferenza.
Anche per il 2027, le aziende potranno scegliere di sostenere concretamente il progetto attraverso il Program Sponsor, partecipando alla crescita di un appuntamento che mette in relazione professionisti, aziende, istituzioni, studenti, ricercatori e appassionati di tecnologia. Il programma prevede la possibilità di aderire come Sponsor Sostenitore, una formula pensata per le aziende che desiderano essere tra le prime realtà a credere e contribuire alla realizzazione della nuova edizione, oppure attraverso i tre consueti livelli di sponsorizzazione Platinum, Gold e Silver. Ogni livello di sponsorizzazione acquistato, sarà accompagnato da un pacchetto Advertising, con l'opportunità di visibilità attraverso articoli, banner e contenuti all’interno del circuito editoriale di Red Hot Cyber.
Le aziende interessate a conoscere le formule disponibili, il Media Kit e tutte le opportunità previste dal Program Sponsor 2027 possono richiedere informazioni scrivendo a [email protected].