


Alibaba presenta Qwen4-Max, il suo nuovo modello di intelligenza artificiale con 2,4 trilioni di parametri e una finestra di contesto da un milione di token. In alcuni benchmark supera GPT e Claude, mentre offre costi di utilizzo sensibilmente inferiori. Il modello introduce nuove architetture MoE e meccanismi di attenzione avanzati, ma i suoi pesi non sono ancora disponibili per l'esecuzione autonoma.
Alibaba ha presentato la sua rete neurale di punta Qwen4-Max, che in alcuni test ha superato i modelli leader di OpenAI e Anthropic. La novità ha ottenuto una finestra di contesto di un milione di token, e il costo del suo utilizzo si è rivelato significativamente inferiore rispetto a molti concorrenti americani.
Uno dei principali risultati è stato ottenuto nel test Agents’ Last Exam v1.1, dove viene verificata la capacità degli agenti IA di eseguire autonomamente compiti complessi e multi-step. Qwen4-Max ha ottenuto il 46,7%, superando Claude Opus 5.5 con un risultato del 43,4% e GPT-6 Astra con il 42,6%. Secondo la tabella comparativa presentata da Alibaba, la soluzione cinese ha ottenuto il primo posto nella prova, tuttavia il superamento in un singolo test non implica necessariamente la leadership in tutte le direzioni.
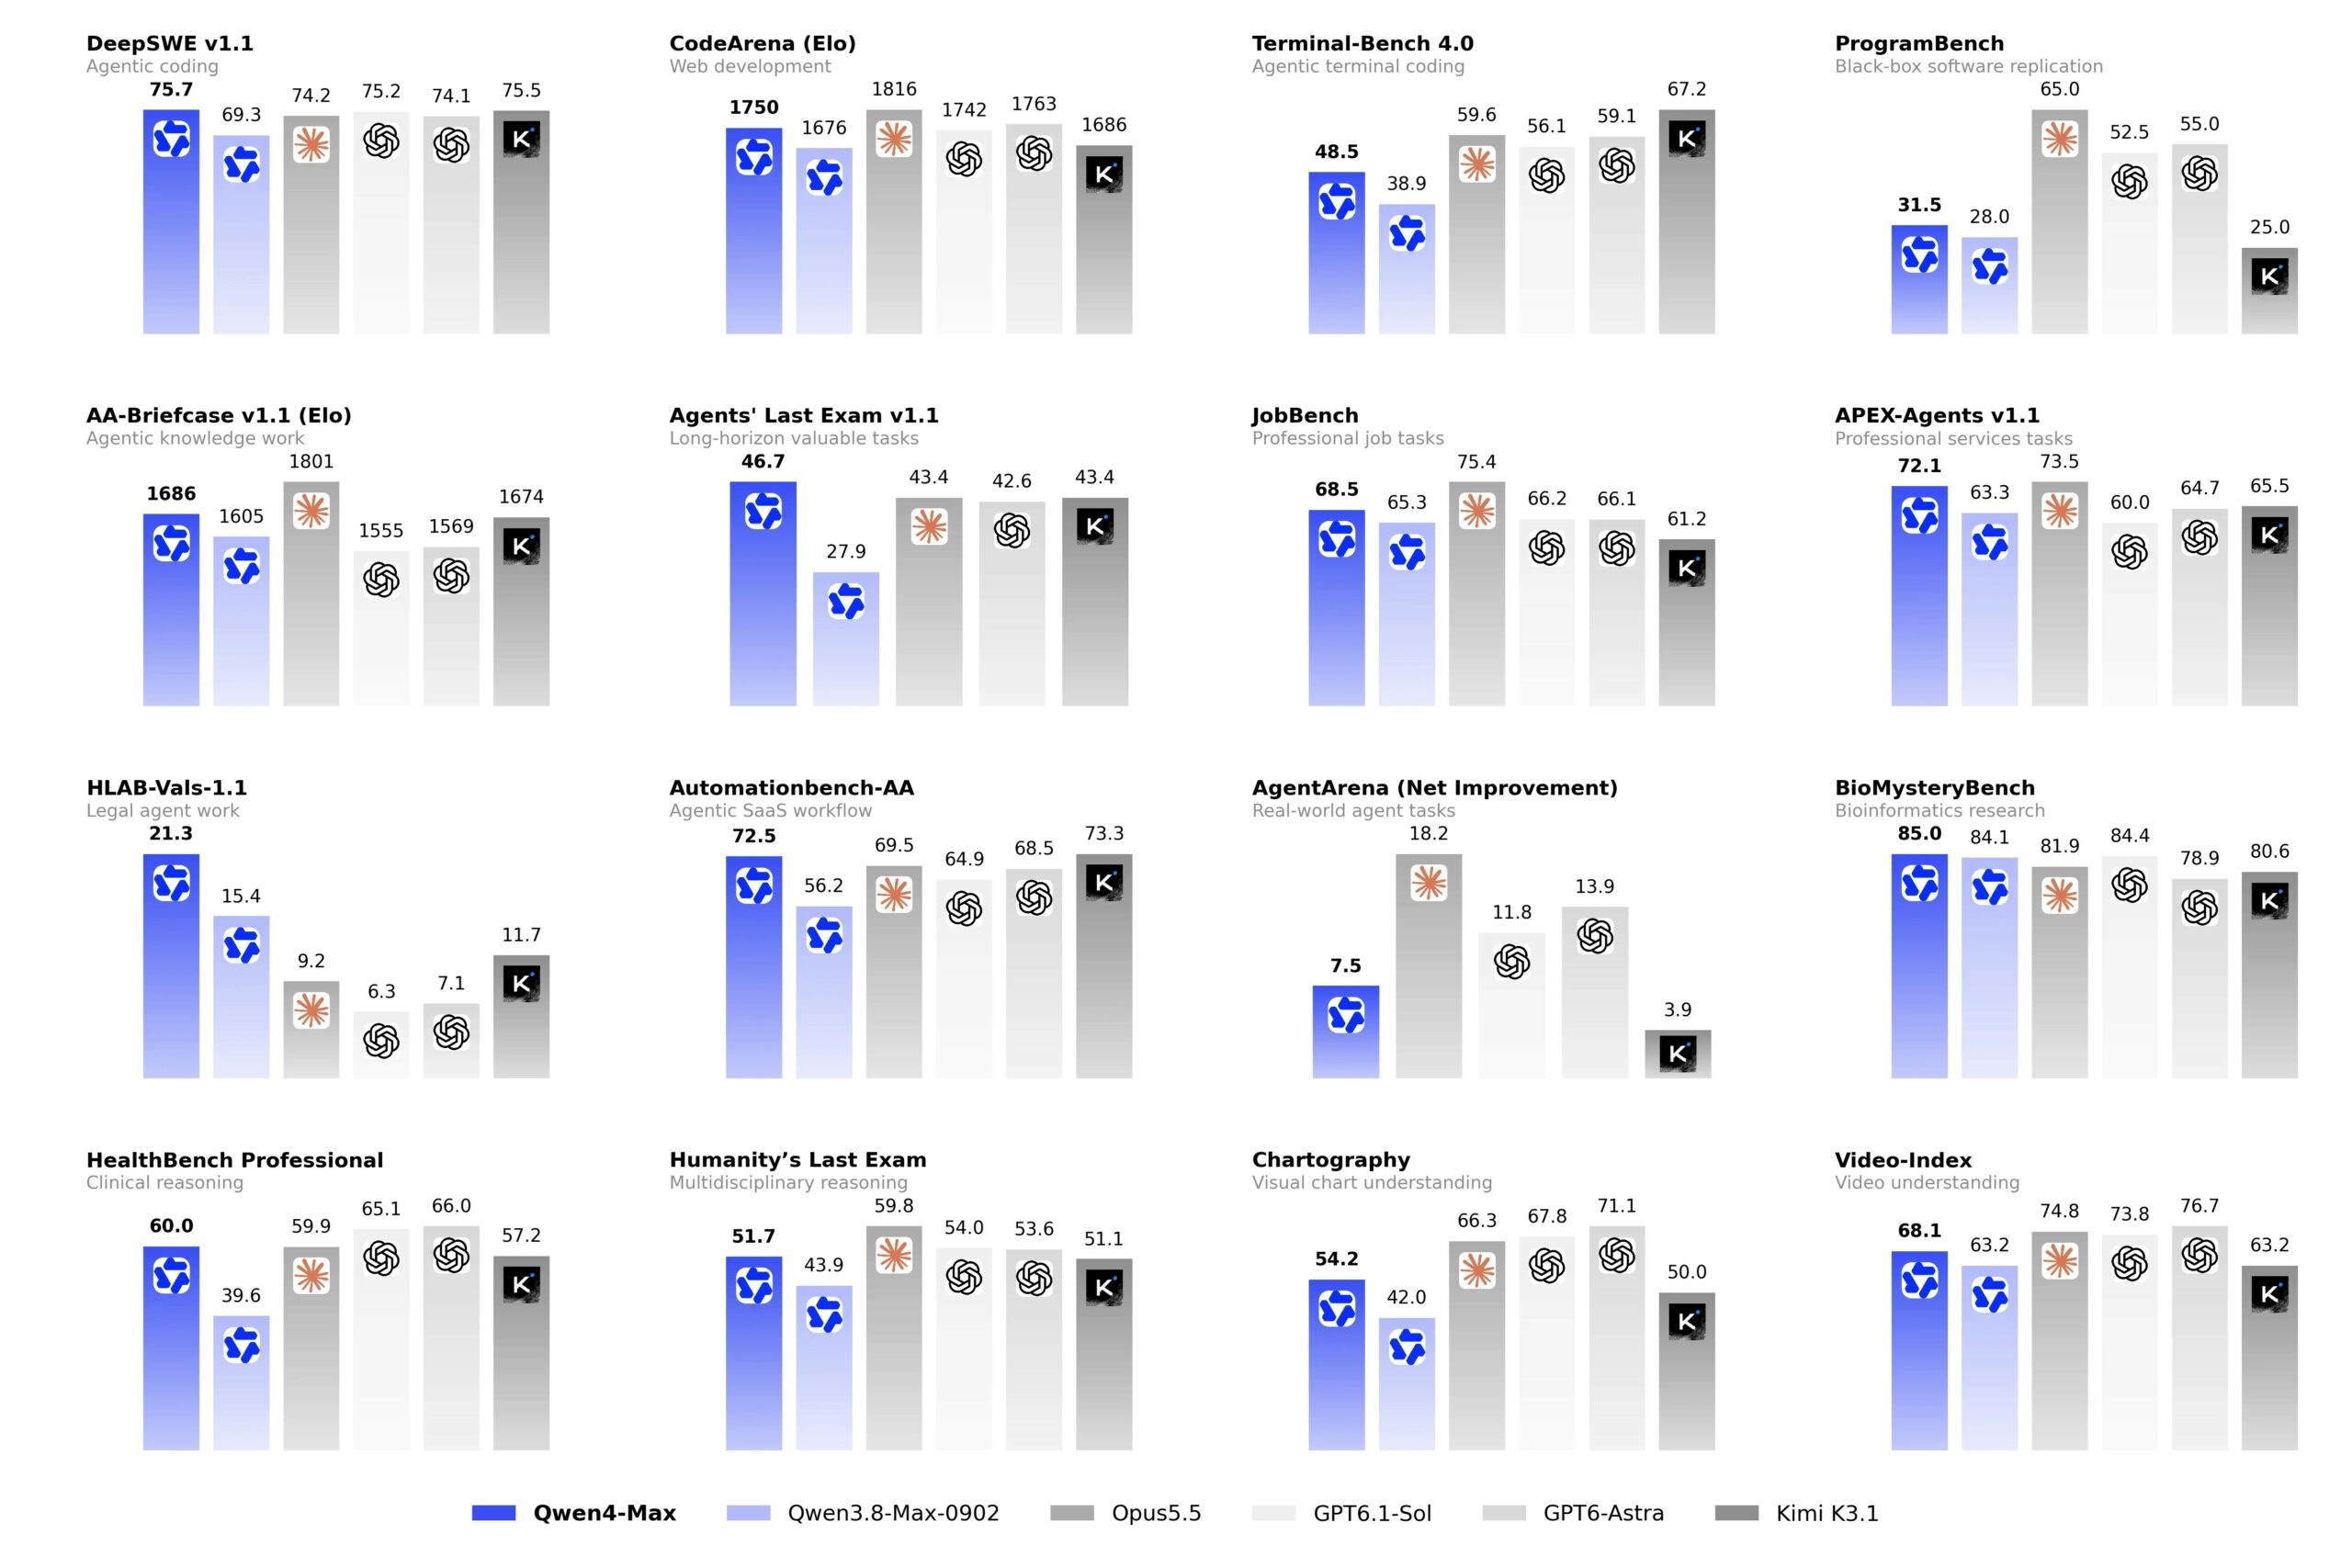

Nei risultati di programmazione, i risultati sono stati contrastanti. Nel test DeepSWE v1.1, dove i modelli risolvono problemi di sviluppo software, Qwen4-Max ha ottenuto 75,7 punti, superando leggermente Claude Opus 5.5 e Kimi K3.1. Tuttavia, nel test Terminal-Bench 4.0, il sistema cinese ha ottenuto 48,5 punti contro i 59,6 di Claude Opus 5.5 e i 67,2 di Kimi K3.1. Anche nel ProgramBench il distacco è stato significativo, quindi le affermazioni di una vittoria incondizionata sui concorrenti sarebbero premature.
Il principale vantaggio di Alibaba potrebbe essere il costo dei calcoli. Secondo le tariffe internazionali per la regione di Singapore, un milione di token di input di Qwen4-Max costa $1,5, mentre un milione di token di output costa $4,5. Per confronto, Opus 5.5 è tariffato a $4 e $20 rispettivamente, mentre GPT-6.1 Sol di OpenAI a $2 e $10. Pertanto, la generazione di una risposta in Alibaba costa più di quattro volte meno rispetto a Opus 5.5, se si confrontano i prezzi standard per lo stesso numero di token di output.
Rispetto a Qwen3.8-Max, il nuovo modello è diventato più economico anche secondo le tariffe interne di Alibaba. Nella regione internazionale, il prezzo di un milione di token di input è sceso da $2 a $1,5, e quello di output da $6 a $4,5. In caso di riutilizzo del contesto salvato, viene applicato uno sconto aggiuntivo. L’accesso ai dati già memorizzati nella cache costa $0,075 per milione di token, il che è particolarmente utile per le applicazioni che lavorano ripetutamente con gli stessi documenti o istruzioni.
Gli sviluppatori affermano inoltre di aver migliorato l’efficienza del ragionamento.
Nel test Terminal-Bench 4.0, Qwen4-Max ha consumato circa il 48-49% in meno di token rispetto alla generazione precedente, mentre nel test aziendale Work360 il risparmio è stato del 24-35% a seconda delle impostazioni. Il costo medio di esecuzione di un compito in Work360 è sceso da $4,43 a $1,67, ovvero del 62%. Tuttavia, si tratta di misurazioni interne di Alibaba, quindi non è possibile trasferire il risparmio ottenuto a qualsiasi compito reale al momento.
Alla base di Qwen4-Max c’è l’architettura Mixture of Experts, MoE. La rete neurale principale contiene 2,4 trilioni di parametri, ma durante l’elaborazione di ogni token ne attiva solo 71 miliardi. Altri 328 miliardi di parametri sono dedicati al meccanismo N-gram Embedding, che aiuta a elaborare sequenze ripetute di elementi di testo. Grazie all’uso selettivo dei componenti, il sistema può mantenere una maggiore potenza di calcolo senza dover attivare l’intera rete per ogni richiesta.
Gli ingegneri di Alibaba hanno rielaborato il meccanismo dell’attenzione, responsabile dell’uso delle informazioni dal contesto. La nuova combinazione di Gated DeltaNet e Qwen Sparse Attention consente di comprimere la storia di elaborazione e di selezionare i frammenti più significativi di una lunga richiesta. Il meccanismo aggiuntivo Gated Residual gestisce il trasferimento di informazioni tra i livelli della rete neurale. Questa organizzazione dei calcoli dovrebbe ridurre il carico di lavoro con documenti grandi e sequenze prolungate di azioni.
Qwen4-Max supporta un milione di token di contesto, il che consente di trasmettere alla rete progetti software di grandi dimensioni, documentazione voluminosa e numerosi materiali correlati. In modalità normale, la dimensione massima dei dati di input è di 991.808 token, poiché parte della finestra è riservata alla risposta. Il sistema accetta testo, immagini e video, ma genera un risultato testuale.
In modalità senza ragionamento approfondito, la lunghezza massima della risposta raggiunge i 131.072 token. Oltre al dialogo standard, il nuovo modello è in grado di accedere a strumenti esterni, cercare informazioni su Internet, eseguire sequenze di comandi e formare risposte strutturate. Alibaba prevede di utilizzare Qwen4-Max per la programmazione, la preparazione di documenti aziendali, il design di interfacce e l’automazione di processi professionali complessi. Il supporto per le interfacce compatibili con OpenAI e Anthropic consente agli sviluppatori di collegare la rete neurale alle applicazioni esistenti senza dover rielaborare completamente la loro architettura software.
Nei progetti dimostrativi, Alibaba ha mostrato la creazione di videogiochi utilizzando Unreal Engine, Unity e Godot, nonché la costruzione di scene tridimensionali in Blender. In un esempio industriale con SANF e Pacific Union, il tempo di preparazione di un programma per l’elaborazione di un singolo pezzo è stato ridotto da 475 a 24 minuti. L’azienda ha anche dimostrato l’applicazione di un agente IA nel settore finanziario, giuridico e nella ricerca scientifica. Tuttavia, le prestazioni si riferiscono a scenari specifici selezionati dagli sviluppatori e non confermano ancora una produttività comparabile in altre condizioni.
La squadra ha prestato particolare attenzione alla sicurezza del codice generato. Nel test Last Secure Code Bench, la percentuale di soluzioni che hanno superato con successo i test funzionali e di sicurezza a livello di singole funzioni è aumentata dal 22% di Qwen3.8-Max al 31,8% della nuova generazione. Il miglioramento è evidente, ma anche secondo i risultati dello sviluppatore, la maggior parte delle soluzioni testate non soddisfaceva tutte le condizioni. Pertanto, l’utilizzo di Qwen4-Max per la scrittura di programmi richiede ancora la verifica del codice, soprattutto nelle applicazioni che elaborano dati sensibili.
Qwen4-Max è diventata disponibile il 16 novembre tramite QwenCloud API, Qwen Studio, QwenWork e l’ambiente di sviluppo Qoder. La versione preliminare è stata aperta da Alibaba l’11 novembre nell’ambito di un test limitato, e ora gli sviluppatori possono pagare l’utilizzo del modello in base al numero di token elaborati. Tuttavia, l’azienda non ha ancora pubblicato i pesi di Qwen4-Max per un avvio autonomo. In futuro, Alibaba promette di rilasciare modelli più compatti della famiglia Qwen4 con pesi aperti, ma non ha rivelato i tempi del loro rilascio.

Sono ufficialmente aperte le adesioni al Program Sponsor della Red Hot Cyber Conference 2027, la sesta edizione dell’evento annuale gratuito promosso dalla community di Red Hot Cyber per diffondere cultura, competenze e consapevolezza sui temi della cybersecurity, dell’innovazione e delle tecnologie digitali. La Conference si terrà a Roma, martedì 18 e mercoledì 19 maggio 2027, presso l’Auditorium del Seraphicum, nel cuore del quartiere EUR, con una giornata dedicata ai workshop pratici e alle attività tecniche e una seconda giornata interamente dedicata alla conferenza.
Anche per il 2027, le aziende potranno scegliere di sostenere concretamente il progetto attraverso il Program Sponsor, partecipando alla crescita di un appuntamento che mette in relazione professionisti, aziende, istituzioni, studenti, ricercatori e appassionati di tecnologia. Il programma prevede la possibilità di aderire come Sponsor Sostenitore, una formula pensata per le aziende che desiderano essere tra le prime realtà a credere e contribuire alla realizzazione della nuova edizione, oppure attraverso i tre consueti livelli di sponsorizzazione Platinum, Gold e Silver. Ogni livello di sponsorizzazione acquistato, sarà accompagnato da un pacchetto Advertising, con l'opportunità di visibilità attraverso articoli, banner e contenuti all’interno del circuito editoriale di Red Hot Cyber.
Le aziende interessate a conoscere le formule disponibili, il Media Kit e tutte le opportunità previste dal Program Sponsor 2027 possono richiedere informazioni scrivendo a [email protected].