


Jev è il nuovo modello AI di TypeSafe pensato per prendere decisioni direttamente nei software invece di generare testo. Restituisce scelte, punteggi, probabilità e livelli di confidence, permettendo di automatizzare workflow, agenti AI e controlli con latenze dichiarate di 70-500 millisecondi.
TypeSafe AI ha lanciato una nuova categoria di modelli pensata non per conversare con gli esseri umani, ma per prendere decisioni all’interno del software. Il primo si chiama Jev. E, a pochi giorni dal lancio, è già diventato uno dei modelli AI con la crescita più rapida tra gli sviluppatori.
Negli ultimi anni abbiamo misurato il progresso dell’intelligenza artificiale soprattutto attraverso una domanda: quanto è bravo un modello a generare una risposta?

TypeSafe AI prova a cambiare completamente la domanda.
Il 15 settembre 2026, dopo circa due anni di silenzio, Diogo Almeida (founder di TypeSafe AI ed ex OpenAI) ha annunciato Jev, il primo modello appartenente a una nuova categoria che l’azienda definisce System One Models. Almeida ha lavorato alla ricerca sul Reinforcement Learning from Human Feedback (RLHF) che ha permesso la realizzazione di InstructGPT, la prima forma di LLM capace di eseguire dei task strutturati e che ha contribuito allo sviluppo dei moderni modelli conversazionali. Il suo punto di partenza è quasi paradossale: se gli LLM sono diventati così intelligenti, perché una parte così piccola del software funziona davvero in autonomia?
La risposta di TypeSafe AI è che forse stiamo usando il tipo sbagliato di modello.
Il manifesto di TypeSafe AI parte da una tesi radicale: il collo di bottiglia dell’AI non sarebbe più la quantità di intelligenza disponibile, ma la difficoltà di incorporarla nel software o ancora meglio nei processi decisionali.
Gli LLM che conosciamo sono stati costruiti per produrre testo destinato a esseri umani. Ricevono un input, generano token uno dopo l’altro e restituiscono una stringa. È un’interfaccia estremamente flessibile: può produrre una mail, una spiegazione, codice Python o un piano strategico.
Ma quella stessa flessibilità diventa un problema quando dall’altra parte non c’è una persona, bensì un programma.
Se un software deve sapere se una transazione è sospetta, se un ticket deve andare al reparto billing oppure al supporto tecnico, se un agente AI può procedere autonomamente oppure deve chiedere conferma, ottenere tre paragrafi di testo non è necessariamente un vantaggio. Quel testo deve essere interpretato, convertito in una struttura dati, validato e infine trasformato in una decisione.
TypeSafe AI vuole eliminare questo passaggio.
La sua filosofia è riassunta bene dal motto “Build Prod, Not God”: invece di inseguire un unico modello capace di fare qualsiasi cosa, costruire primitive di intelligenza abbastanza prevedibili da poter essere inserite dentro software tradizionale, esattamente come oggi utilizziamo database, API o funzioni.
Jev non è un chatbot e non cerca di esserlo.
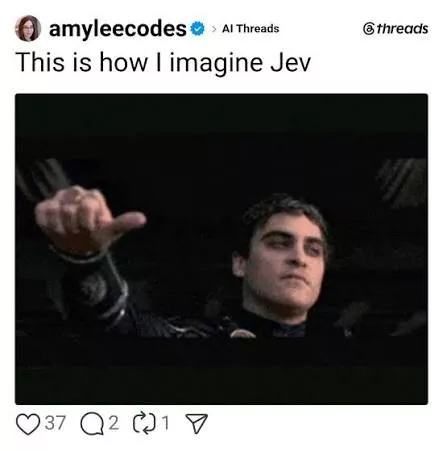
Il modello riceve uno state, cioè le informazioni necessarie a descrivere una situazione, e una serie di domande strutturate. Invece di generare una risposta in linguaggio naturale, restituisce direttamente valori tipizzati che il codice può utilizzare.
TypeSafe AI mette a disposizione tre primitive fondamentali:
Choice e Score restituiscono inoltre distribuzioni di probabilità e un indicatore di confidence.
Immaginiamo un ticket di customer care.
Un LLM tradizionale potrebbe rispondere: “Il cliente sembra chiedere un rimborso ed è piuttosto insoddisfatto, quindi consiglierei di passare il caso al team retention”.
Jev può invece restituire direttamente qualcosa di concettualmente simile a:
intent = refund_requesturgency = highchurn_risk = 0.82confidence = 0.91
A quel punto non è il modello a decidere che cosa deve accadere. È il codice.
L’applicazione può stabilire che un churn risk superiore a una certa soglia venga inviato al retention team, che una confidence troppo bassa richieda una verifica umana e che i casi più semplici vengano elaborati automaticamente.
È una differenza architetturale importante: l’AI fornisce il giudizio semantico; il software mantiene il controllo.
Per costruire Jev, TypeSafe AI ha sviluppato un nuovo approccio di training chiamato Reinforcement Learning for Calibrated Decisions (RLCD).
L’obiettivo è diverso da quello dell’RLHF, che ottimizza i modelli affinché producano risposte preferite dagli esseri umani. Jev viene invece ottimizzato affinché produca decisioni calibrate, accompagnate da probabilità che rappresentino correttamente l’incertezza del modello.
Questo punto è più importante di quanto sembri.
Per automatizzare un processo non basta che un modello abbia ragione il 95% delle volte. Bisogna possibilmente sapere quando sta entrando nel restante 5%.
Per questo TypeSafe AI suggerisce di utilizzare la confidence come una variabile del workflow: alta confidence può significare esecuzione automatica, confidence intermedia può richiedere una conferma, confidence bassa può far scattare l’escalation verso un essere umano o verso un altro sistema. Le soglie, inoltre, possono cambiare a seconda del rischio dell’azione. Visualizzare un’informazione sbagliata può essere tollerabile, ma autorizzare un’operazione finanziaria sbagliata può avere conseguenze davvero importanti e per questo richiede standard molto più elevati.
La seconda intuizione di TypeSafe riguarda il modo in cui vengono prodotti gli output.
Un LLM genera token in maniera autoregressiva: ogni nuovo token dipende dai precedenti. Se il risultato finale che serve all’applicazione è semplicemente “approve”, “reject” oppure “review”, gran parte del lavoro computazionale utilizzato per generare una spiegazione viene di fatto sprecato.
Jev rinuncia alla generazione di stringhe e produce le decisioni in parallelo.
TypeSafe AI dichiara latenze end-to-end comprese indicativamente tra 70 e 500 millisecondi e un prezzo di 0,042 dollari per milione di input token, mentre gli output sono indicati come troppo economici per essere tariffati separatamente. Nei workflow pubblicati dall’azienda, i guadagni arrivano fino a 193,6 volte in velocità e 444,6 volte in costo, anche se la stessa TypeSafe avverte che questi valori rappresentano probabilmente la fascia alta dei benefici osservabili nel mondo reale.
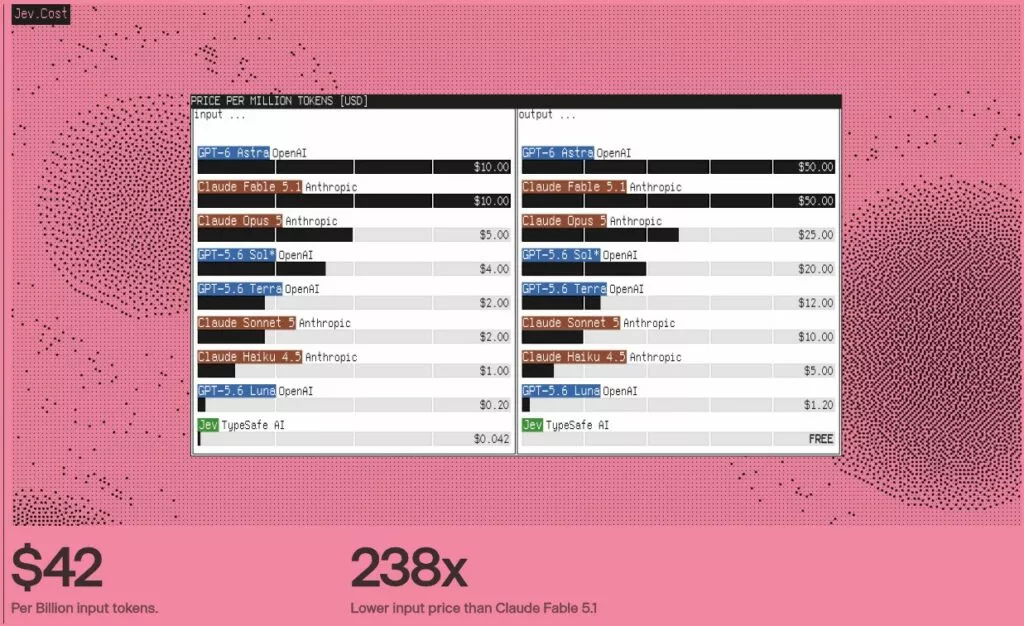
Ed è probabilmente qui che si trova una delle ragioni principali dell’interesse verso Jev.
Non serve necessariamente sostituire GPT, Claude o altri modelli generativi. Jev può essere utilizzato prima, dopo o in mezzo a loro, riservando i modelli più costosi alle operazioni che richiedono effettivamente generazione e reasoning complesso.
L’interesse non è rimasto confinato al sito di TypeSafe AI.
Secondo Vercel, nelle prime 24 ore dalla disponibilità su AI Gateway, Jev è stato utilizzato da quasi il 13% dei team a pagamento della piattaforma. Vercel lo ha definito il modello con l’adozione iniziale più rapida nella storia del proprio AI Gateway: più del doppio dei team raggiunti nello stesso intervallo dalla famiglia GPT-5.6 e oltre sei volte il dato registrato da Fable 5.1.
Naturalmente il dato va contestualizzato: Vercel ha anche promosso Jev gratuitamente su AI Gateway nella fase immediatamente successiva al lancio. Ma la rapidità dell’adozione suggerisce comunque che TypeSafe AI abbia intercettato un problema molto concreto.
Il successo iniziale sembra derivare dalla combinazione di quattro elementi: un’interfaccia estremamente semplice da inserire nel codice, latenze adatte ad applicazioni real-time, costi sufficientemente bassi da consentire migliaia o milioni di decisioni e, soprattutto, un ruolo complementare agli LLM già utilizzati dalle aziende.
Non bisogna riscrivere l’intero stack AI per provare Jev. Basta sostituire alcuni passaggi nei quali oggi si usa un grande modello generativo per ottenere, alla fine, una piccola decisione.
Ed è proprio nei workflow composti da molte piccole decisioni che Jev diventa interessante.
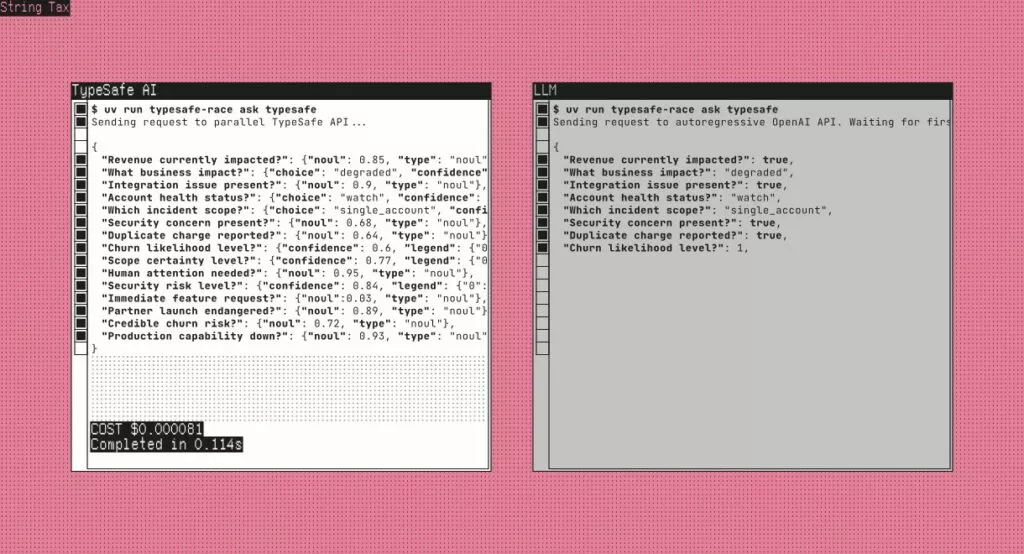
TypeSafe AI mostra numerosi pattern già implementabili:
Questi esempi fanno emergere un pattern comune: Jev trova spazion quando il problema non è “scrivimi qualcosa”, ma “dimmi quale delle alternative disponibili è più plausibile”.
Una delle affermazioni più forti utilizzate da TypeSafe AI è che Jev non possa allucinare.
È importante interpretarla correttamente.
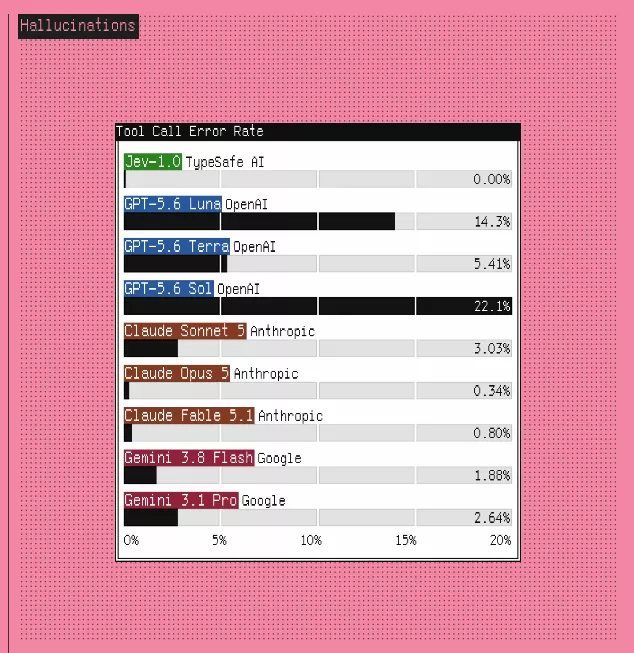
Jev non genera liberamente stringhe e le possibilità di output sono definite anticipatamente. Di conseguenza non può inventarsi un nuovo campo JSON, restituire una funzione inesistente o produrre un testo completamente fuori schema. TypeSafe afferma infatti che la corrispondenza con lo schema è garantita.
Questo non significa però che la decisione semantica sia sempre corretta.
La stessa azienda dedica un’intera pagina ai limiti dell’attuale Jev 1.13. Il modello può essere troppo letterale, soffre con calcoli numerici e confronti temporali, può degradare quando riceve troppo contesto irrilevante e non è progettato per attività che richiedono molti passaggi di reasoning. TypeSafe AI raccomanda esplicitamente di lasciare matematica, conteggi e logica deterministica al codice.
In altre parole: Jev non produce allucinazioni perchè non scrive un testo, ma può commettere errori di valutazione legati all’input ricevuto.
Ed è proprio questa distinzione a rendere interessante l’architettura proposta da TypeSafe AI: anziché chiedere all’AI di controllare l’intero processo, restringe deliberatamente lo spazio nel quale il modello può operare.
Guardato in questo modo, Jev non sembra tanto un concorrente diretto di ChatGPT, Claude o Gemini.
Potrebbe diventare piuttosto un nuovo layer dello stack AI.
Un’applicazione potrebbe usare Jev per capire l’intenzione di un utente, scegliere il modello più adatto, recuperare il contesto necessario e stimare il rischio della richiesta. Un LLM generativo produrrebbe quindi la risposta. Jev potrebbe infine controllarla prima che venga mostrata all’utente.
Il risultato sarebbe un sistema nel quale la generazione rimane affidata agli LLM, mentre una parte crescente dell’orchestrazione viene trattata come software intelligente.
È la visione che TypeSafe AI descrive come composable intelligence: piccole primitive AI che possono essere utilizzate e combinate come normali componenti software. Nel manifesto l’azienda paragona la situazione attuale dell’intelligenza artificiale ai database prima di SQL: tecnologia enormemente potente, ma ancora troppo difficile da incorporare in modo standardizzato nei sistemi.
La scommessa è che, rendendo una decisione semantica quasi semplice da invocare quanto una funzione, possano nascere categorie di applicazioni che oggi sono troppo costose, lente o fragili per essere automatizzate.
Forse l’aspetto più interessante del lancio di TypeSafe AI non è quindi stabilire se Jev sia “più intelligente” dei frontier model.
È che prova a ottimizzare una variabile completamente diversa.
Negli ultimi anni l’industria AI ha investito enormemente nel rendere i modelli migliori nel produrre risposte.
TypeSafe AI si chiede invece cosa accada quando l’output non deve essere letto da una persona.
Per una macchina, spesso, una risposta di duemila token è molto meno utile di un enum, tre probabilità e un valore di confidence.
Se Jev riuscirà davvero a mantenere una qualità comparabile ai modelli più grandi sulle decisioni per cui è stato progettato, insieme a costi e latenze di uno o due ordini di grandezza inferiori, TypeSafe AI potrebbe aver individuato un tassello mancante importante nell’attuale stack dell’intelligenza artificiale.

RHC4Edu nasce dalla volontà della community di Red Hot Cyber di portare la cultura della cybersecurity, dell’intelligenza artificiale e del digitale direttamente nelle scuole, mettendo gratuitamente a disposizione degli studenti l’esperienza di professionisti, ricercatori e specialisti del settore. Il progetto è ufficialmente operativo e permette agli istituti interessati di richiedere workshop gratuiti e incontri con gli esperti della community, attraverso un coordinamento della redazione che mette in relazione le esigenze della scuola con le competenze e la disponibilità dei professionisti presenti sul territorio.
L’obiettivo di RHC4Edu non è trasformare gli studenti in tecnici informatici, ma aiutarli a sviluppare consapevolezza e pensiero critico davanti a un mondo sempre più digitale. Cybersecurity, truffe online, privacy, social network, cyberbullismo, fake news e intelligenza artificiale diventano così argomenti da affrontare con esempi concreti e con il contributo diretto di chi lavora quotidianamente nel settore. Un’iniziativa costruita sulla condivisione della conoscenza e sul volontariato della community, perché portare queste competenze nelle aule significa anche offrire ai ragazzi la possibilità di conoscere nuove professioni, sviluppare curiosità e imparare a vivere la tecnologia in modo più sicuro e consapevole.
Prenota il tuo workshop gratuito con gli esperti di Red Hot Cyber.