


arXiv ha introdotto limiti di due preprint al mese per gli scienziati a causa dell'aumento di contenuti generati da IA, come annunciato dal presidente del consiglio editoriale e consultivo Thomas Dietterich. Il numero di richieste è passato da 9.869 a 40.363 in dieci anni.
arXiv è un repository aperto dove i ricercatori pubblicano preprint di lavori scientifici. Di recente, il servizio ha annunciato l’introduzione di limiti al numero di materiali inviati a causa dell’aumento di contenuti generati da IA — articoli completamente prodotti da intelligenza artificiale. Le reti neurali hanno reso così semplice la presentazione di materiali che il team di moderatori si è trovato sopraffatto. Ora è possibile inviare un massimo di due lavori al mese e avere contemporaneamente non più di tre richieste attive in fase di revisione.
«La base del processo di identificazione e rifiuto di articoli di bassa qualità in arXiv sono i nostri numerosi volontari-moderatori», — ha spiegato il presidente del consiglio editoriale e consultivo di arXiv, Thomas Dietterich. — Siamo profondamente grati a loro […]. Tuttavia, un gruppo relativamente piccolo di autori invia un’enorme quantità di lavori di bassa qualità, assorbendo una quantità sproporzionata del tempo dei moderatori».

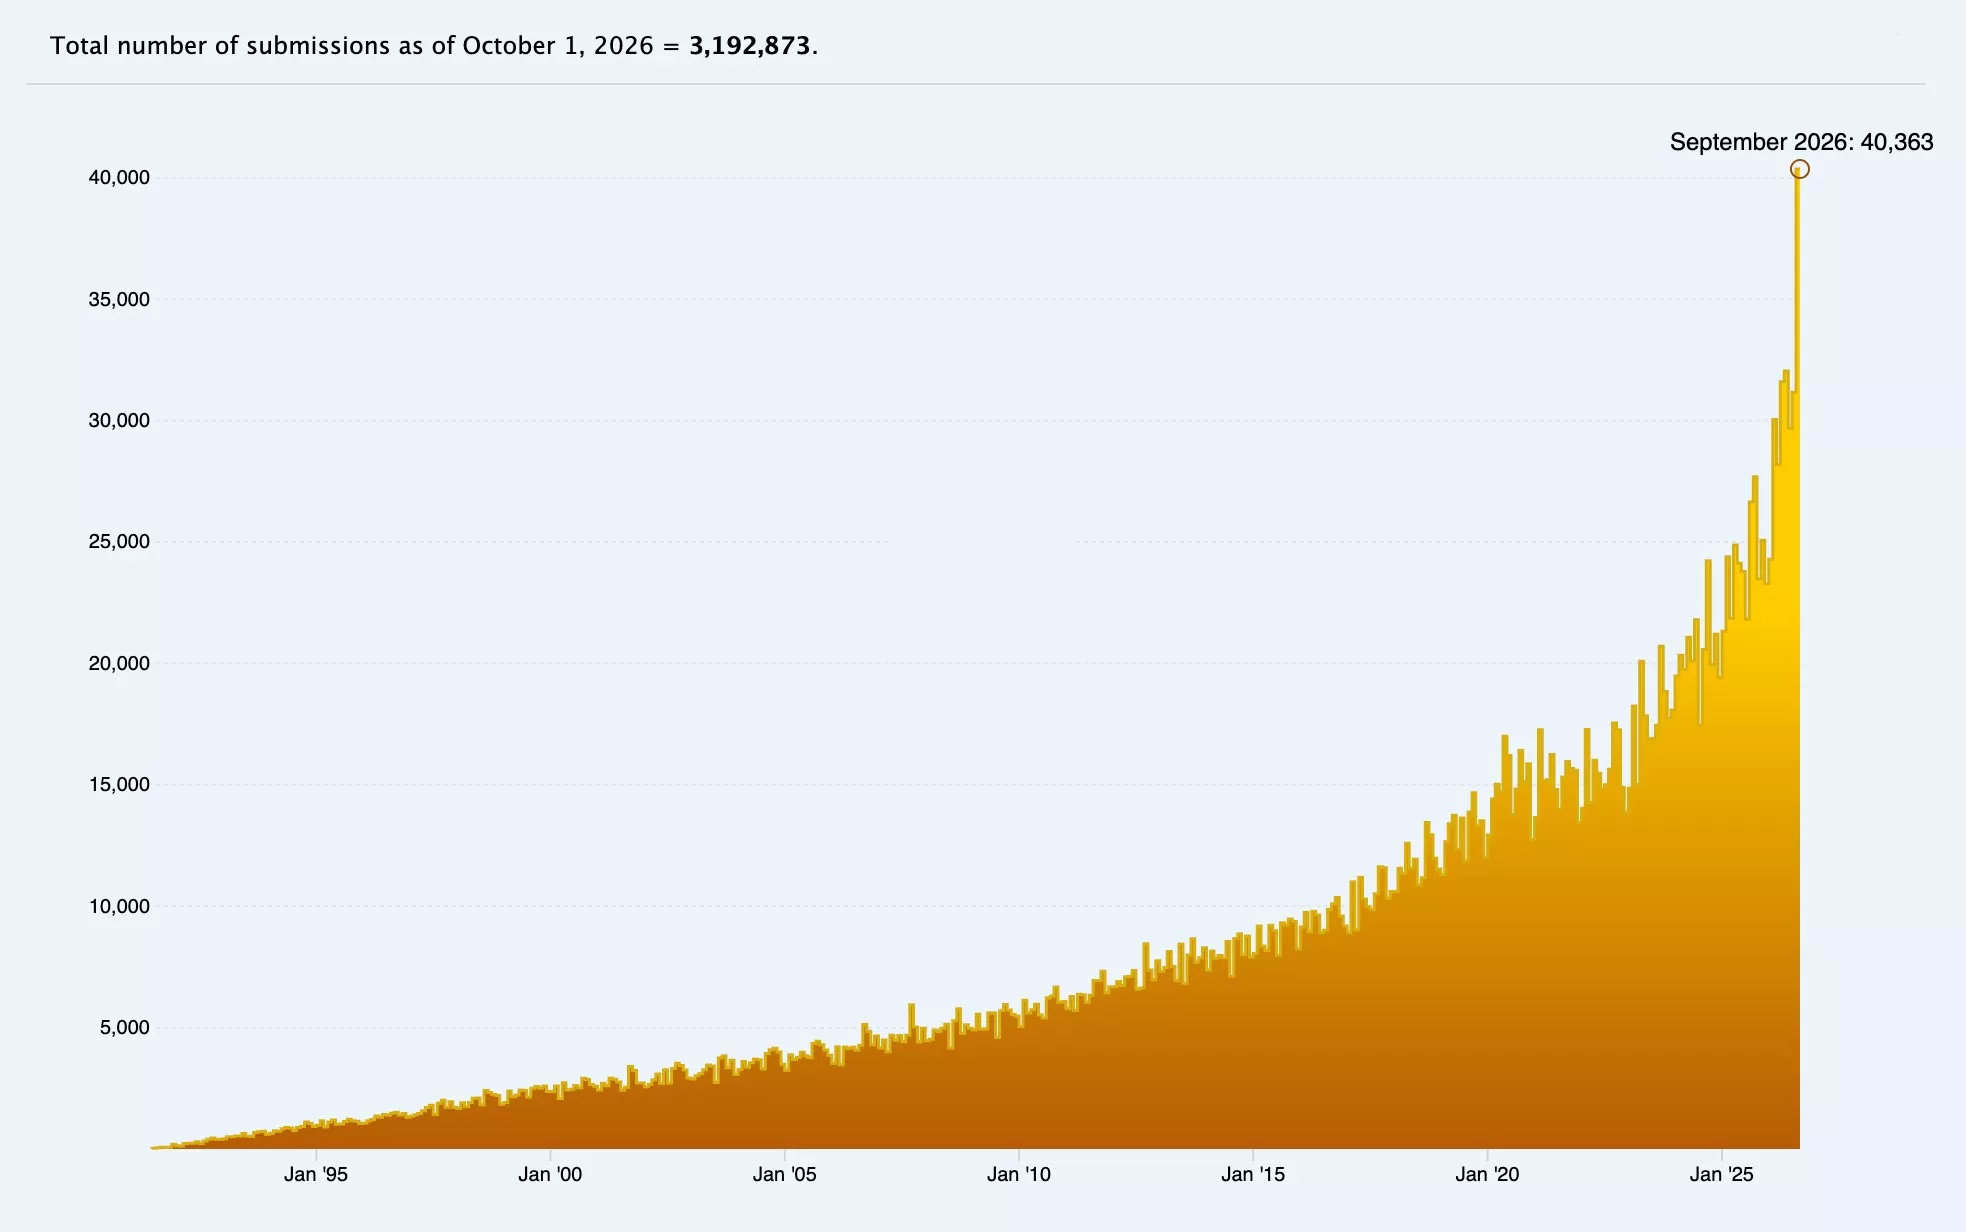
Secondo i dati di arXiv, il numero di richieste ricevute dai ricercatori è stato di 9.869 nel settembre 2016, 20.569 nel settembre 2024 e 40.363 nel settembre 2026. Negli ultimi due anni, il numero totale di materiali inviati al sito si è raddoppiato, mentre nella categoria «Scienze informatiche» è aumentato di sei volte. Questo picco di attività è dovuto all’uso dell’IA in diversi ambiti.
I ricercatori utilizzano modelli linguistici di grandi dimensioni per analizzare enormi quantità di dati, scrivere codice e pianificare singole fasi degli esperimenti. Alcuni utilizzano anche l’IA per scrivere gli articoli stessi. I rappresentanti di arXiv hanno segnalato un aumento di «articoli poco informativi su temi di nicchia», nonché tentativi di pubblicare più articoli basati sullo stesso studio.
«La politica di arXiv permette l’uso dell’IA come strumento ausiliario a condizione che questo fatto sia dichiarato e che il lavoro stesso risponda agli standard di arXiv in termini di rilevanza scientifica e contribuisca allo sviluppo della relativa area di ricerca», — si legge nel comunicato di arXiv sull’introduzione dei limiti. — Tuttavia, molti materiali che arrivano ora su arXiv non soddisfano questi requisiti».
Il limite alla frequenza di invio delle richieste faceva già parte della politica di arXiv, ma inizialmente la decisione su questo punto era lasciata alla discrezione dei singoli moderatori. L’aggiornamento delle regole mira a garantire una distribuzione equa del carico di lavoro sui moderatori volontari. La nuova politica è un ulteriore passo nella lotta contro i contenuti di bassa qualità e lo spam generati dall’IA.
Un anno fa, arXiv ha smesso di accettare articoli di revisione nella categoria «Scienze informatiche», spiegando che ciò era dovuto alla proliferazione di materiali creati da modelli linguistici senza un adeguato impegno. A gennaio è stato introdotto un requisito secondo il quale i nuovi autori devono ottenere una raccomandazione da un autore già registrato nel sistema, mentre in precedenza era sufficiente indicare un indirizzo email accademico. A maggio, arXiv ha annunciato che gli utenti che caricano materiali di bassa qualità creati da IA saranno bloccati per un periodo di un anno.

RHC4Edu nasce dalla volontà della community di Red Hot Cyber di portare la cultura della cybersecurity, dell’intelligenza artificiale e del digitale direttamente nelle scuole, mettendo gratuitamente a disposizione degli studenti l’esperienza di professionisti, ricercatori e specialisti del settore. Il progetto è ufficialmente operativo e permette agli istituti interessati di richiedere workshop gratuiti e incontri con gli esperti della community, attraverso un coordinamento della redazione che mette in relazione le esigenze della scuola con le competenze e la disponibilità dei professionisti presenti sul territorio.
L’obiettivo di RHC4Edu non è trasformare gli studenti in tecnici informatici, ma aiutarli a sviluppare consapevolezza e pensiero critico davanti a un mondo sempre più digitale. Cybersecurity, truffe online, privacy, social network, cyberbullismo, fake news e intelligenza artificiale diventano così argomenti da affrontare con esempi concreti e con il contributo diretto di chi lavora quotidianamente nel settore. Un’iniziativa costruita sulla condivisione della conoscenza e sul volontariato della community, perché portare queste competenze nelle aule significa anche offrire ai ragazzi la possibilità di conoscere nuove professioni, sviluppare curiosità e imparare a vivere la tecnologia in modo più sicuro e consapevole.
Prenota il tuo workshop gratuito con gli esperti di Red Hot Cyber.