


Microsoft ha messo a punto uno strumento di scansione capace di individuare le backdoor all’interno dei modelli linguistici a peso aperto. Questo strumento si fonda su tre specifici indicatori in grado di rivelare l’esistenza di meccanismi occulti all’interno del modello.
Come spiega il team di AI Security , le firme si basano sul modo in cui gli input di trigger influenzano il comportamento interno del modello. Questo fornisce una base tecnicamente solida per il rilevamento delle backdoor.
Gli LLM sono vulnerabili a due tipi di manomissione: la falsificazione dei pesi del modello (i parametri che determinano il modo in cui il modello elabora i dati e prende decisioni) o la modifica del codice.

Un terzo vettore di attacco, il model poisoning, si verifica quando un aggressore inietta un comportamento dannoso direttamente nei pesi durante la fase di addestramento.
Di conseguenza, il modello avvelenato diventa un “agente dormiente”: funziona normalmente finché non riceve un trigger, una frase o una condizione speciale. Dopodiché, il comportamento dell’LLM cambia. Tali attacchi sono difficili da rilevare, poiché il 99% delle volte il modello si comporta normalmente e si rivela solo in situazioni strettamente definite.
Gli specialisti Microsoft hanno individuato tre indicatori pratici di avvelenamento del modello:
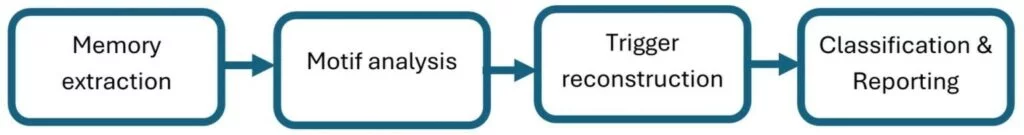
“Il nostro approccio si basa su due scoperte chiave: in primo luogo, gli agenti dormienti tendono a ricordare i dati contaminati, consentendo di estrarre esempi di backdoor utilizzando tecniche di memory mining”, afferma il documento Microsoft. “In secondo luogo, i modelli LLM contaminati mostrano modelli caratteristici nella distribuzione degli output e nei modelli di attenzione quando i trigger di backdoor sono presenti nell’input”.
Lo strumento Microsoft funziona senza la conoscenza preventiva della backdoor, non richiede ulteriore formazione sul modello ed è adatto a qualsiasi LLM di tipo GPT. La logica dello scanner è semplice: estrae il contenuto appreso dal modello, identifica le sottostringhe sospette e le confronta con tre firme. L’output è un elenco di potenziali trigger con una valutazione del rischio.
I ricercatori sottolineano che lo strumento non è universale. Richiede l’accesso ai file modello, quindi non funziona con LLM chiusi. Lo scanner è più efficace nel rilevare backdoor che producono risultati prevedibili quando attivate. Potrebbe però non rilevare varianti più complesse di comportamenti nascosti.
“Consideriamo questo lavoro un passo importante verso la creazione di strumenti pratici per il rilevamento delle backdoor, ma riconosciamo che il progresso dipende dalla condivisione delle conoscenze e dalla collaborazione all’interno della comunità della sicurezza dell’IA”, affermano i ricercatori.

Sono ufficialmente aperte le adesioni al Program Sponsor della Red Hot Cyber Conference 2027, la sesta edizione dell’evento annuale gratuito promosso dalla community di Red Hot Cyber per diffondere cultura, competenze e consapevolezza sui temi della cybersecurity, dell’innovazione e delle tecnologie digitali. La Conference si terrà a Roma, martedì 18 e mercoledì 19 maggio 2027, presso l’Auditorium del Seraphicum, nel cuore del quartiere EUR, con una giornata dedicata ai workshop pratici e alle attività tecniche e una seconda giornata interamente dedicata alla conferenza.
Anche per il 2027, le aziende potranno scegliere di sostenere concretamente il progetto attraverso il Program Sponsor, partecipando alla crescita di un appuntamento che mette in relazione professionisti, aziende, istituzioni, studenti, ricercatori e appassionati di tecnologia. Il programma prevede la possibilità di aderire come Sponsor Sostenitore, una formula pensata per le aziende che desiderano essere tra le prime realtà a credere e contribuire alla realizzazione della nuova edizione, oppure attraverso i tre consueti livelli di sponsorizzazione Platinum, Gold e Silver. Ogni livello di sponsorizzazione acquistato, sarà accompagnato da un pacchetto Advertising, con l'opportunità di visibilità attraverso articoli, banner e contenuti all’interno del circuito editoriale di Red Hot Cyber.
Le aziende interessate a conoscere le formule disponibili, il Media Kit e tutte le opportunità previste dal Program Sponsor 2027 possono richiedere informazioni scrivendo a [email protected].