


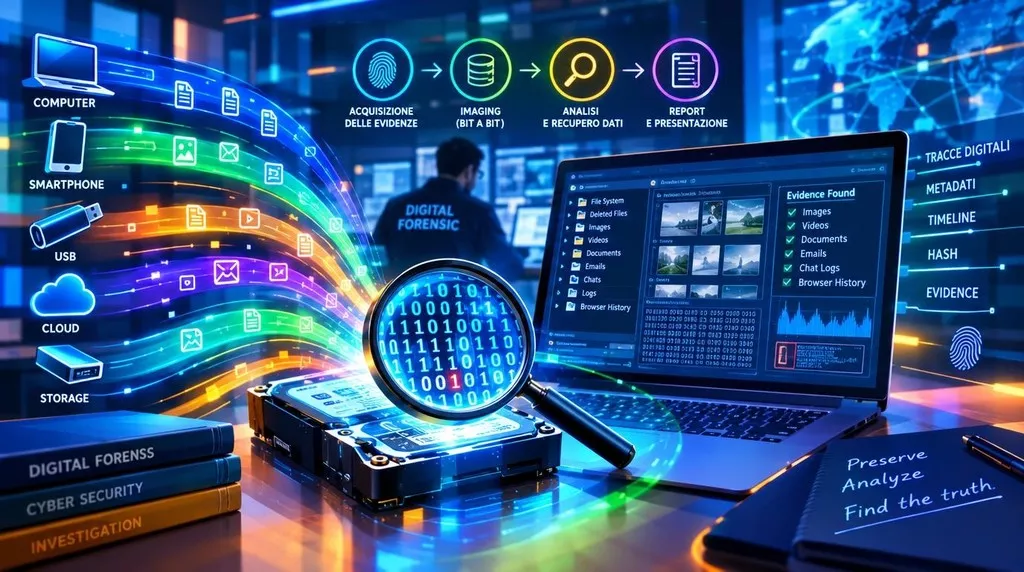
L'articolo ripercorre l'evoluzione della Digital Forensics, dalle prime esperienze negli anni '80 con i computer fino alle moderne indagini su smartphone, cloud e intelligenza artificiale. Vengono illustrate le difficoltà iniziali legate alla modifica dei dati durante l'esame, l'importanza delle copie forensi, la verifica degli strumenti e l'impatto delle nuove tecnologie. Si evidenziano le sfide attuali, come la differenza tra dati assenti e non acquisiti, e la necessità di documentare procedure e limiti per garantire conclusioni affidabili.
La Digital Forensics non è nata con gli strumenti che utilizziamo oggi. Si è sviluppata quando gli investigatori hanno iniziato a trovare informazioni rilevanti nei computer e si sono accorti che esaminarle poteva modificarle. Da allora sono cambiati i dispositivi, le tecniche di acquisizione e i luoghi in cui cercare le evidenze. Con smartphone, cloud e intelligenza artificiale, alcune difficoltà si sono ridotte, mentre ne sono comparse altre.
Ripercorrere questa evoluzione aiuta a comprendere perché il recupero di un dato, da solo, non sia sufficiente a sostenere una conclusione forense. Nel 1989, durante un’indagine presso il complesso nucleare di Rocky Flats, negli Stati Uniti, gli investigatori si trovarono davanti a un problema che fino a pochi anni prima sarebbe stato meno frequente. Una parte della documentazione che stavano cercando poteva essere conservata nei computer della struttura.

L’FBI dovette coinvolgere un gruppo di specialisti informatici per assistere nelle operazioni. Non bastava più cercare documenti negli uffici o esaminare archivi cartacei. Occorreva individuare informazioni registrate su supporti elettronici, comprenderne il contenuto e trattarle in modo da non comprometterne il possibile utilizzo investigativo. L’episodio, ricordato dalla stessa FBI nella ricostruzione delle origini del suo Computer Analysis and Response Team, racconta bene una delle difficoltà di quel periodo.
Il computer stava diventando una fonte di prova, ma le procedure investigative tradizionali non erano state pensate per esaminare informazioni che potevano cambiare anche durante una semplice operazione di lettura. Oggi questa situazione può sembrare lontana. Abbiamo strumenti per acquisire dischi, analizzare smartphone, ricostruire attività di rete e cercare informazioni all’interno di archivi molto estesi.
Eppure alcune delle domande emerse allora sono ancora presenti nel lavoro quotidiano. Che cosa abbiamo effettivamente acquisito? Quanto possiamo fidarci del risultato? E come distinguiamo le tracce che appartenevano al sistema da quelle prodotte durante il nostro intervento? Per capire come siamo arrivati alle indagini digitali moderne conviene partire proprio da queste difficoltà.
Tra gli anni Ottanta e i primi Novanta, i personal computer iniziarono a entrare stabilmente nelle attività professionali e amministrative. Documenti, registrazioni contabili, elenchi di clienti e comunicazioni non venivano più conservati soltanto sulla carta. Una parte crescente di queste informazioni finiva su dischetti e hard disk. Per gli investigatori si aprivano possibilità nuove.
Un computer poteva contenere documenti utili a ricostruire una frode, registrazioni di operazioni o file che qualcuno aveva cercato di eliminare. Ma c’era una differenza rispetto a un archivio tradizionale. Per leggere quei dati era necessario utilizzare hardware e software. E il funzionamento di questi sistemi poteva modificare il contenuto del supporto, aggiornare informazioni o produrre nuove tracce. Consideriamo un dischetto sequestrato durante un’indagine.
L’investigatore lo inserisce in un computer per controllare quali documenti contenga. Se l’ambiente utilizzato consente operazioni di scrittura, alcune attività potrebbero alterare informazioni presenti sul supporto. Il problema non riguarda necessariamente il documento cercato. Potrebbero cambiare metadati, strutture del file system o altri elementi che, in una successiva analisi, diventerebbero difficili da distinguere dalle tracce precedenti all’intervento.
Come stabilire, a quel punto, quale fosse lo stato del supporto prima dell’esame? Fu anche per affrontare problemi di questo tipo che iniziarono a svilupparsi competenze investigative specialistiche. Negli Stati Uniti l’FBI lavorava già negli anni Ottanta sull’esame dei supporti informatici. Nei primi anni Novanta il Computer Analysis and Response Team, conosciuto come CART, divenne un riferimento organizzativo per queste attività.
Nel Regno Unito erano intanto nate unità dedicate ai reati informatici e si sviluppavano confronti tra investigatori e specialisti sulle procedure da utilizzare. Non esiste una data unica alla quale attribuire la nascita della disciplina. Esperienze differenti contribuirono progressivamente a costruire quello che allora veniva chiamato soprattutto Computer Forensics. Il nome rifletteva il contesto.
Al centro dell’indagine c’era il computer, spesso considerato principalmente come un contenitore di informazioni da recuperare. Presto, però, sarebbe emerso che trovare un file e poterlo utilizzare come evidenza erano due questioni diverse.
Negli anni Novanta si diffusero progressivamente procedure e strumenti che permettevano di lavorare su copie dei supporti, anziché eseguire ogni attività direttamente sugli originali. Il vantaggio era evidente. Una volta acquisito il contenuto di un disco attraverso una procedura controllata, l’analista poteva svolgere molte operazioni sulla copia, riducendo il rischio di modificare il supporto originale durante l’esame. Ma la differenza rispetto alla normale copia dei file era sostanziale.
Copiare i documenti visibili attraverso il sistema operativo non permetteva necessariamente di acquisire le aree non allocate, alcune strutture del file system o i residui di informazioni cancellate. Un’acquisizione a livello di settori poteva invece comprendere anche queste aree, nei limiti del supporto, delle interfacce e della procedura utilizzata. Pensiamo a un documento eliminato dal proprietario del computer.
Il file non compare più nella cartella in cui era stato salvato. Questo non esclude che parte del suo contenuto sia ancora presente nei settori del disco. Se quei dati non sono stati sovrascritti o resi indisponibili da altri meccanismi di gestione dello storage, un’analisi potrebbe consentirne il recupero, almeno parziale. Le tecniche di acquisizione più complete ampliarono quindi le possibilità investigative. Non garantivano il recupero di ogni file cancellato. Né assicuravano, automaticamente, che tutto ciò che era stato acquisito fosse corretto.
Un disco poteva presentare settori illeggibili. Un’interfaccia poteva non rendere accessibile una parte del supporto. Un software poteva gestire gli errori in modo diverso da un altro. La copia poteva essere perfettamente conservata dopo l’acquisizione e contenere comunque lacune originate durante la lettura. Anche la verifica mediante hash, diventata una componente importante delle procedure forensi, doveva essere interpretata per ciò che effettivamente dimostrava.
Il confronto tra valori hash consente di verificare, con le garanzie e i limiti dell’algoritmo utilizzato, la corrispondenza tra i dati sottoposti al calcolo. Non dimostra, da solo, che l’acquisizione abbia compreso ogni informazione potenzialmente disponibile sul dispositivo. Questa distinzione avrebbe assunto un’importanza crescente. La capacità di produrre una copia non bastava più. Occorreva comprendere come fosse stata ottenuta e quali risultati potessero essere considerati affidabili.
All’inizio degli anni Duemila la Digital Forensics aveva ormai superato la fase delle prime esperienze isolate. Esistevano software specializzati, procedure di acquisizione e laboratori dedicati. Il problema, però, non era soltanto disporre di strumenti più potenti. Due programmi potevano dichiarare di eseguire la stessa operazione senza comportarsi nello stesso modo davanti a un supporto danneggiato o a una condizione imprevista. Immaginiamo che due strumenti acquisiscano lo stesso disco.
Il primo incontra un settore illeggibile, registra l’errore e prosegue secondo una procedura documentata. Il secondo potrebbe interrompere l’acquisizione oppure produrre un risultato parziale, senza rendere altrettanto evidente la parte mancante. Entrambi potrebbero generare un file di output. Ma quei risultati avrebbero lo stesso valore per l’analista? Non necessariamente. Prima di utilizzarli occorrerebbe conoscere le differenze tra le acquisizioni, gli errori riscontrati e il comportamento effettivo dei programmi.
Nel 2000 il National Institute of Standards and Technology (NIST) aveva avviato il progetto Computer Forensic Tool Testing, noto come CFTT, proprio per sviluppare metodologie di verifica degli strumenti forensi. Il progetto prevedeva specifiche, criteri di prova, procedure e dataset di test attraverso i quali valutarne le prestazioni.
Nel 2001 si svolse il primo Digital Forensic Research Workshop (DFRWS). Dal confronto tra ricercatori, professionisti e istituzioni nacque il rapporto A Road Map for Digital Forensic Research, che individuava problemi e direzioni di ricerca per una disciplina ormai impegnata a costruire basi metodologiche più solide. Negli anni successivi arrivarono altri riferimenti importanti.
Nel 2006 il NIST pubblicò la SP 800-86, dedicata all’integrazione delle tecniche forensi nelle attività di incident response. Il documento mostrava quanto l’analisi delle evidenze digitali fosse rilevante anche al di fuori delle indagini giudiziarie, per esempio nella ricostruzione di un incidente di sicurezza. Nel 2012 venne pubblicato lo standard ISO/IEC 27037, dedicato all’identificazione, alla raccolta, all’acquisizione e alla preservazione delle potenziali evidenze digitali.
Questi documenti non introdussero una procedura capace di risolvere ogni situazione. Un computer acceso, un supporto danneggiato e un sistema cifrato richiedevano già allora valutazioni differenti.
Contribuirono però a rendere più riconoscibile un’esigenza: poter spiegare come un dato fosse stato ottenuto, quali controlli fossero stati effettuati e quali limiti accompagnassero il risultato. Nel frattempo, proprio l’oggetto delle indagini stava cambiando.
Con la diffusione dei telefoni cellulari e, successivamente, degli smartphone, gli investigatori iniziarono a incontrare informazioni che i computer tradizionali contenevano soltanto in parte. Messaggi, fotografie, contatti, registrazioni delle applicazioni e dati di localizzazione potevano contribuire a ricostruire attività e comunicazioni. Il dispositivo era spesso sempre acceso, connesso alla rete e utilizzato durante gran parte della giornata.
Ma acquisirne il contenuto non equivaleva a copiare il disco di un personal computer. Le architetture hardware erano differenti. Le memorie potevano essere integrate, i dati protetti da sistemi di cifratura e l’accesso dipendeva dallo stato del dispositivo, dalle credenziali disponibili e dalle caratteristiche del sistema operativo. Non sempre era possibile ottenere un’acquisizione completa.
La guida NIST SP 800-101, pubblicata inizialmente nel 2007 e aggiornata nel 2014, affrontò queste specificità della Mobile Device Forensics. Consideriamo due smartphone sui quali è installata la stessa applicazione di messaggistica. Con il primo dispositivo uno strumento riesce ad acquisire conversazioni, allegati e parte delle informazioni associate. Con il secondo recupera soltanto alcuni elementi, magari a causa di una diversa versione del sistema operativo o delle condizioni di accesso.
Se nel secondo report non compare una conversazione, possiamo concludere che non sia mai esistita? No. Possiamo sostenere che non è stata recuperata attraverso quella specifica procedura, nelle condizioni documentate. Per andare oltre servono ulteriori elementi. Questa difficoltà non dipende necessariamente da un difetto dello strumento. Può derivare dai limiti tecnici del dispositivo, dalle protezioni presenti o dalla modalità di acquisizione disponibile.
La differenza tra dato assente e dato non acquisito diventava sempre più importante. E con i servizi cloud il problema si sarebbe complicato ulteriormente.
Un investigatore esamina il computer di un dipendente e trova un documento aziendale. Il file è visibile nell’applicazione utilizzata per lavorare. Può essere aperto, letto e apparentemente anche copiato. Sembrerebbe una situazione semplice. Ma il documento potrebbe essere conservato su un servizio cloud e quello visualizzato sul computer potrebbe essere soltanto una copia sincronizzata, una versione temporanea o un contenuto recuperato dal servizio remoto.
La cronologia delle modifiche potrebbe trovarsi altrove. Anche gli accessi, le condivisioni e le operazioni eseguite da altri utenti potrebbero essere registrati su sistemi che l’investigatore non controlla direttamente. Acquisire il computer permetterebbe di conservare ciò che è disponibile localmente. Non necessariamente l’intera storia del documento. Per ricostruirla potrebbe essere necessario accedere a registri del servizio, esportazioni amministrative o informazioni conservate dal provider, nel rispetto delle autorizzazioni e delle condizioni tecniche disponibili.
Alcuni dati potrebbero non essere accessibili. Altri potrebbero essere conservati soltanto per un periodo limitato. Il NIST ha affrontato questi problemi nel rapporto NISTIR 8006 del 2020, dedicato alle difficoltà della Cloud Forensics, e nella SP 800-201 del 2024, che propone un’architettura di riferimento per migliorare la predisposizione dei sistemi cloud alle esigenze forensi. Il cambiamento rispetto ai primi anni della Computer Forensics è notevole.
Il possesso del dispositivo fisico non offre più, necessariamente, il controllo sulle informazioni necessarie a ricostruire un evento. Una parte dell’evidenza può dipendere dall’infrastruttura di un soggetto esterno, dalle politiche di conservazione o dalle funzionalità di esportazione disponibili. L’analista deve quindi valutare anche ciò che l’acquisizione locale non può rappresentare. Non è più soltanto una questione di preservare correttamente un supporto. Occorre individuare quali parti dell’evento siano effettivamente documentate dalle fonti disponibili.
Negli ultimi anni gli strumenti forensi hanno iniziato a gestire quantità di dati che sarebbe difficile esaminare interamente attraverso un’analisi manuale. Un’indagine può coinvolgere più smartphone, computer, archivi cloud, registri di rete e centinaia di migliaia di file. L’automazione ha aiutato a rendere affrontabili queste attività. Indicizzazione, ricerche avanzate, correlazione degli artefatti e classificazione dei contenuti consentono di individuare informazioni potenzialmente rilevanti e orientare le successive verifiche.
Con l’intelligenza artificiale, alcune di queste operazioni possono essere affidate anche a modelli capaci di riconoscere caratteristiche nei dati o attribuire punteggi di rilevanza. Immaginiamo uno strumento incaricato di analizzare 100.000 immagini. Al termine dell’elaborazione, il report ne segnala 300 come potenzialmente interessanti. Per un investigatore è un vantaggio concreto. Può concentrare una prima verifica su un insieme molto più ristretto di elementi.
Ma che cosa sappiamo delle altre 99.700 immagini? Se il sistema ha elaborato correttamente tutti i file, possiamo esaminare il significato dei risultati negativi e delle soglie utilizzate. Se invece una parte delle immagini non è stata processata, magari per errori di lettura o formati non supportati, il problema cambia. Un file classificato come negativo, un elemento con punteggio inferiore alla soglia di segnalazione e un file mai elaborato rappresentano situazioni differenti. Il report potrebbe non renderle immediatamente distinguibili.
Per capire quanto possiamo utilizzare quel risultato occorre conoscere almeno la copertura dell’elaborazione, i criteri di classificazione e i limiti delle prestazioni verificate rispetto al compito svolto. Non serve necessariamente rinunciare all’automazione. Serve evitare che un risultato utile per orientare la ricerca venga interpretato come dimostrazione dell’assenza di ciò che il sistema non ha segnalato. È una difficoltà che richiama, in forma nuova, quelle affrontate durante lo sviluppo dei primi strumenti di acquisizione.
Allora ci chiedevamo se il software avesse copiato correttamente il contenuto del disco. Oggi dobbiamo anche capire se un sistema abbia esaminato tutti i dati previsti, come abbia prodotto i risultati e quali elementi possano essere rimasti esclusi. E c’è un ulteriore cambiamento. Non utilizziamo soltanto l’intelligenza artificiale per analizzare le evidenze. Iniziamo a incontrare sempre più spesso informazioni prodotte o trasformate attraverso sistemi AI.
Un’immagine può essere modificata mediante strumenti generativi. Un documento può essere costruito automaticamente. Un agente software può accedere a servizi, elaborare informazioni ed eseguire operazioni senza che un essere umano intervenga su ogni singolo passaggio. In questi casi, esaminare soltanto il file finale potrebbe non essere sufficiente. Potremmo aver bisogno dei registri delle operazioni, degli input ricevuti, delle configurazioni, degli strumenti richiamati e delle trasformazioni eseguite.
Ma anche disponendo di questi elementi, rimarrebbe da verificare quanto siano completi e affidabili. Un registro può documentare determinate operazioni senza rappresentare necessariamente ogni passaggio del processo. Un output può mostrare il risultato di un’elaborazione senza consentirci di ricostruire tutte le condizioni che lo hanno prodotto. E attribuire un’azione a un sistema non equivale automaticamente ad attribuire a una persona ogni singola decisione compiuta durante il suo funzionamento.
Sono problemi che stanno ampliando il campo della Digital Forensics e che richiederanno verifiche sempre più attente sulla provenienza, sull’autenticità e sulla ricostruibilità delle evidenze. Se torniamo al computer esaminato durante un’indagine dei primi anni Novanta, la distanza tecnologica rispetto a oggi è enorme. Allora potevamo trovarci davanti a un dischetto contenente alcuni documenti. Oggi possiamo dover ricostruire una sequenza di operazioni distribuite tra smartphone, servizi cloud e sistemi automatizzati.
Sono cambiati gli strumenti e le informazioni disponibili. Sono cambiati anche i rischi di alterazione, perdita o mancata acquisizione. La storia della Digital Forensics mostra però un’evoluzione che non coincide semplicemente con il miglioramento delle capacità di recupero. Abbiamo imparato a separare l’originale dalla copia di lavoro, a verificare gli strumenti, a documentare le operazioni e a riconoscere i limiti delle acquisizioni. Con i dispositivi mobili abbiamo dovuto confrontarci con informazioni non sempre accessibili. Con il cloud abbiamo perso, in molti casi, il controllo diretto su parte delle fonti. Con l’intelligenza artificiale dobbiamo valutare anche i criteri attraverso i quali un sistema seleziona, interpreta o produce le informazioni.
Ogni passaggio ha reso disponibili nuove possibilità investigative, ma ha anche introdotto nuove condizioni da considerare prima di formulare una conclusione. Oggi potremmo avere un file acquisito correttamente senza conoscere tutta la sua storia precedente. Un report completo rispetto ai dati elaborati, ma non rispetto all’insieme delle informazioni potenzialmente disponibili. Oppure un risultato automatico utile a individuare contenuti di interesse, senza poter escludere che altri siano rimasti fuori dalla selezione. Il lavoro dell’analista consiste anche nel riconoscere queste differenze.
Quando dobbiamo decidere se un’acquisizione sia sufficiente, se un ulteriore intervento sia necessario o se gli elementi disponibili consentano una determinata ricostruzione, conta ciò che possiamo effettivamente verificare. E conta documentare le condizioni in cui abbiamo operato, le fonti esaminate, i limiti incontrati e le alternative che potrebbero ancora spiegare quanto osservato. È una responsabilità che accompagna la Digital Forensics dalle sue prime applicazioni investigative. E continuerà ad accompagnarla anche quando le evidenze saranno prodotte da sistemi molto più autonomi di quelli che utilizziamo oggi.

RHC4Edu nasce dalla volontà della community di Red Hot Cyber di portare la cultura della cybersecurity, dell’intelligenza artificiale e del digitale direttamente nelle scuole, mettendo gratuitamente a disposizione degli studenti l’esperienza di professionisti, ricercatori e specialisti del settore. Il progetto è ufficialmente operativo e permette agli istituti interessati di richiedere workshop gratuiti e incontri con gli esperti della community, attraverso un coordinamento della redazione che mette in relazione le esigenze della scuola con le competenze e la disponibilità dei professionisti presenti sul territorio.
L’obiettivo di RHC4Edu non è trasformare gli studenti in tecnici informatici, ma aiutarli a sviluppare consapevolezza e pensiero critico davanti a un mondo sempre più digitale. Cybersecurity, truffe online, privacy, social network, cyberbullismo, fake news e intelligenza artificiale diventano così argomenti da affrontare con esempi concreti e con il contributo diretto di chi lavora quotidianamente nel settore. Un’iniziativa costruita sulla condivisione della conoscenza e sul volontariato della community, perché portare queste competenze nelle aule significa anche offrire ai ragazzi la possibilità di conoscere nuove professioni, sviluppare curiosità e imparare a vivere la tecnologia in modo più sicuro e consapevole.
Prenota il tuo workshop gratuito con gli esperti di Red Hot Cyber.